Unsere Einschätzung: Nutzungsbasierte Plattform für generative Medien mit über 1,000 produktionsreifen Modellen und flexibler GPU-Skalierung, ideal für Entwickler, die KI-Funktionen ohne feste Verpflichtungen einbauen.
Wichtigste Einschränkung: Kein Pauschalabo; die Kosten steigen mit der Nutzung
Von den Redakteuren des AI Tool Atlas.
Auf Basis der offiziellen Dokumentation des Anbieters; wir haben dieses Produkt nicht selbst getestet. Was „dokumentierte Übersicht“ bedeutet
Ist fal das Richtige für Sie?
Nutzungsbasierte Plattform für generative Medien mit über 1,000 produktionsreifen Modellen und flexibler GPU-Skalierung, ideal für Entwickler, die KI-Funktionen ohne feste Verpflichtungen einbauen. Auf Basis der Dokumentation des Anbieters, nicht in einem praktischen Test.
Am besten für: Entwickler, die Apps für generative Medien bauen
Auch gut geeignet für
KI-Startups
ML-Teams, die GPUs benötigen
Ein anderes Tool in Betracht ziehen, wenn sie brauchen Pauschalpreise
Oder wenn
Nicht-Entwickler, die Tools mit Oberfläche bevorzugen
Sie suchen ausschließlich Infrastruktur für Training
fal in den Nachrichten
Schlagzeilen von US-Medien, automatisch ausgewählt – keine Empfehlungen. Aktualisiert Oct 12, 2026
Für: Single-GPU development and fine-tuning at lower cost than B300
Limits
Full SSH access
Billed hourly minimum
1 mehr
Single-GPU instance
Enthält
80GB VRAM H100 GPU
Full SSH control
2 mehr
Persistent storage for code and data
Development and fine-tuning optimized
API inklusive
Nutzungsobergrenzen, Guthaben und Zusatzkosten
Gebühren externer Zahlungsdienstleister; bei großen Ausgaben können Kosten für ausgehenden Datenverkehr anfallen
Was ist fal und wie funktioniert es?
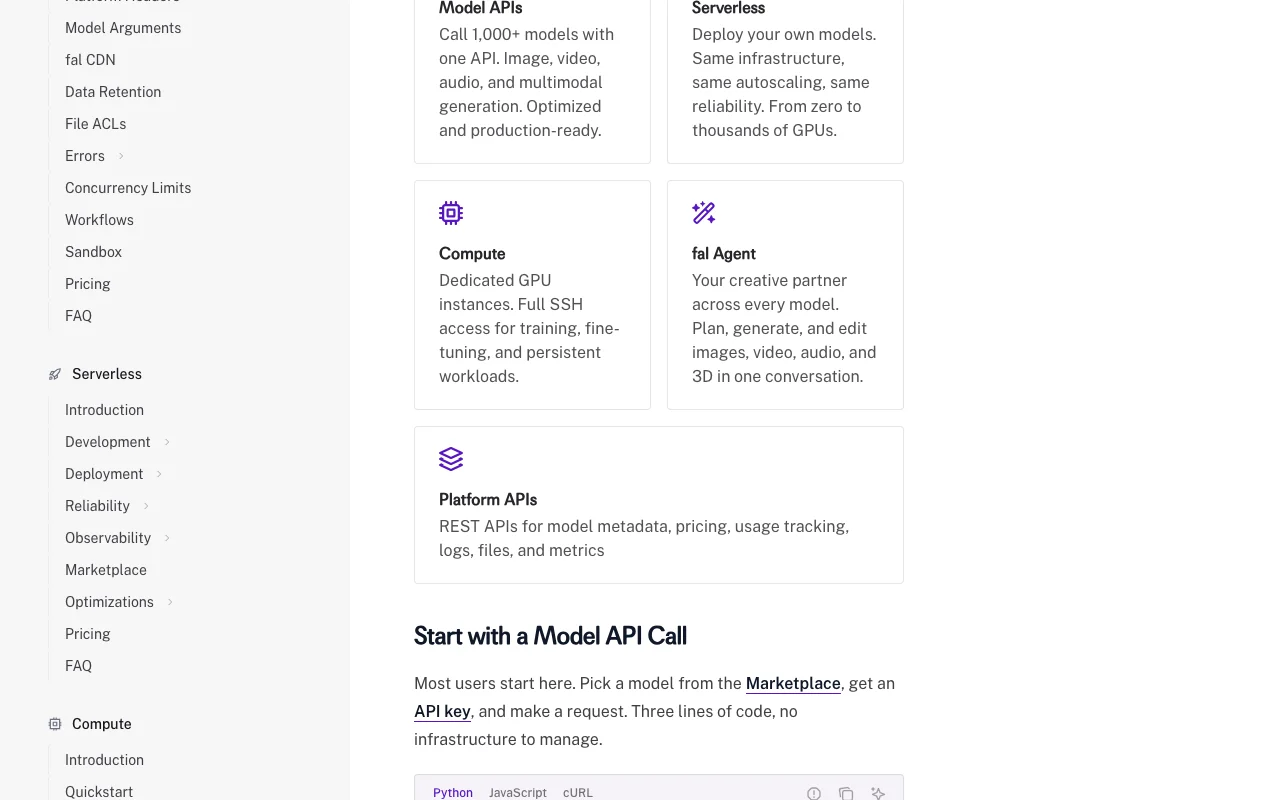
fal ist eine Plattform für generative Medien für Entwickler. Sie stellt über 1,000 produktionsreife Bild-, Video-, Audio- und 3D-Modelle hinter einer einheitlichen API bereit, darunter Modelle von Drittanbietern wie FLUX, Veo, Kling und Seedream.
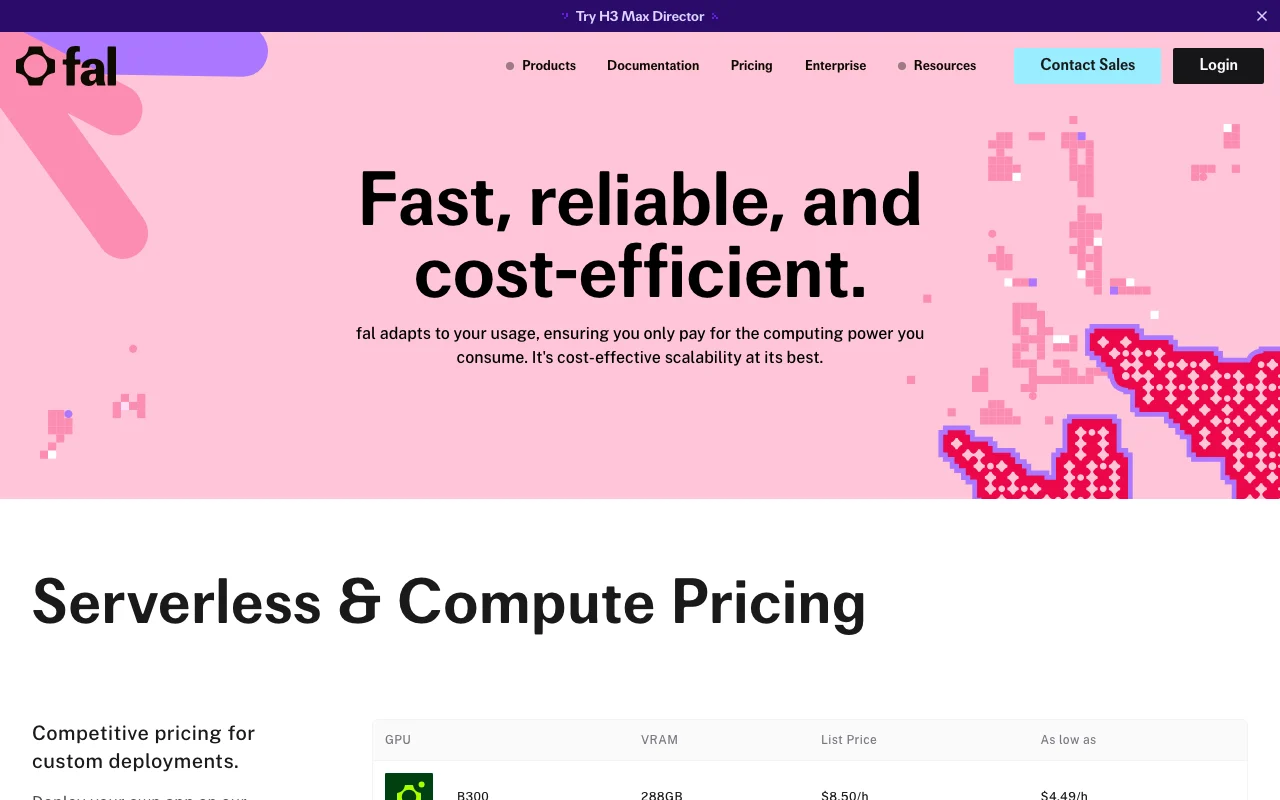
Neben den Modell-APIs bietet fal Serverless-GPU-Deployments für eigene oder feinabgestimmte Modelle sowie dedizierte Rechencluster für das Training. Abgerechnet wird nutzungsbasiert, bei Modell-APIs nach Ausgabe und bei GPUs stundenweise.
Offizielle Website von fal: So stellt sich das Produkt selbst dar. fal.ai, erfasst Oct 1, 2026
Was Sie liefern und was Sie erhalten
Was Sie fal geben und was zurückkommt, laut Dokumentation
Sie liefern
Text-Prompts
Referenzbilder oder -videos
Audiodateien
Eigener Modellcode (für das Deployment)
Sie erhalten zurück
Erzeugte Bilder, Videos, Audioinhalte und 3D-Modelle
Sprachsynthese und Soundeffekte
Ergebnisse der Modellinferenz
Wo Sie es nutzen können
Plattformen
Web, API
Konto
Erforderlich
Modelle / Versionen
Über 1,000 produktionsreife Modelle
Die besten Einsatzzwecke für fal
Die Szenarien erarbeiten unsere Redakteure anhand der Dokumentation; das tatsächliche Ergebnis hängt von Ihrer Eingabe und Ihrem Tarif ab.
Viele generative Modelle über eine API vergleichen
Wer
Produktteams und KI-Forscher
Sie liefern
Dieselbe Eingabe (Text/Bild/Audio) für mehrere Modelle
Erwartetes Ergebnis
Ergebnisse nebeneinander, um die Modellqualität zu bewerten
Benötigter Tarif
Modell-APIs (nutzungsbasiert)
Einschränkung
Die Kosten steigen mit jedem Modellvergleich; beschränkt auf Modelle im fal Marketplace Quelle (öffnet in neuem Tab)
Wichtige Funktionen und ihre praktischen Grenzen
Funktionsüberblick auf der offiziellen Website. fal.ai, erfasst Oct 1, 2026
Einheitliche API für über 1,000 generative Modelle
Leitet einen einzigen API-Aufruf an über 1,000 Bild-, Video-, Audio-, Musik-, 3D- und Sprachmodelle weiter Einmal bauen, viele Modelle testen, ohne die Integration neu zu entwerfen
Zugriff: API über die fal-SDKs (Python, JavaScript), REST oder den Web-PlaygroundLimit: Verfügbarkeit und Leistung der Modelle variieren; für manche Modelle gelten regionale EinschränkungenQuelle (öffnet in neuem Tab)
Web-Playground und Sandbox
Browserbasierte Oberfläche, um beliebige Modelle zu testen, Parameter anzupassen und Ergebnisse zu vergleichen Modelle vor der Integration ohne Code bewerten
Zugriff: Web-App auf fal.ai; zum Stöbern ist keine Registrierung nötig, für Inferenz aber ein API-SchlüsselLimit: Der Playground dient nur zur Information; produktive Apps erfordern eine API-IntegrationQuelle (öffnet in neuem Tab)
Serverless-GPU-Deployments
Eigenen Python-Code mit fal.App bereitstellen; skaliert automatisch von 0 auf über 1000 GPUs Proprietäre oder feinabgestimmte Modelle ohne Cold-Start-Optimierung ausführen
Zugriff: fal CLI (fal deploy) und Web-Dashboard; Abrechnung pro Sekunde AusführungszeitLimit: Nur Python für das Deployment; erfordert die Abstraktion fal.AppQuelle (öffnet in neuem Tab)
Dedizierte H100-/H200-/B200-/B300-Rechenleistung
Ganze GPU-Instanzen mit vollem SSH-Zugang für Training, Fine-Tuning oder Batch-Jobs mieten Lang laufende Workloads zu einem festen Stundenpreis ohne Autoscaling-Overhead ausführen
Zugriff: fal CLI (fal compute create) und Dashboard; stündliche Abrechnung der ganzen InstanzLimit: Manuelle Skalierung nötig; die volle Stunde wird unabhängig von der Auslastung berechnetQuelle (öffnet in neuem Tab)
fal: Stärken und Grenzen
Gründe für die Wahl von fal
Sie zahlen nur für die Nutzung, mit veröffentlichten Preisen pro Ausgabe Planbare Kosten für Wenignutzer; keine versteckten Gebühren und keine Abo-BindungdokumentiertQuelle (öffnet in neuem Tab)
Große Auswahl an Bild-, Video- und Audiomodellen Nutzer können topaktuelle Modelle wie FLUX, Kling und MiniMax ausprobieren, ohne die Plattform zu wechselndokumentiertQuelle (öffnet in neuem Tab)
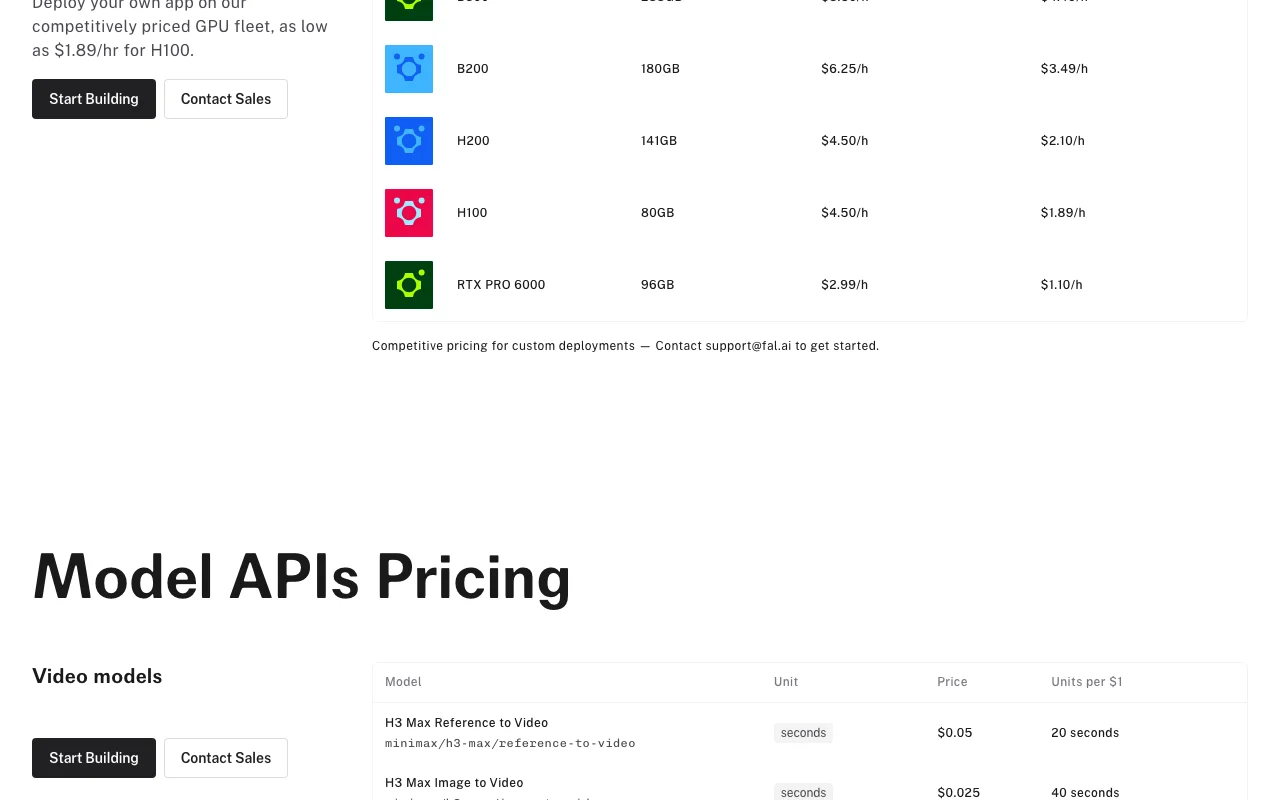
GPU-Preise sind öffentlich einsehbar (H100 ab $1.89/h) Transparente Preise erleichtern die Budgetplanung und den Vergleich mit AlternativendokumentiertQuelle (öffnet in neuem Tab)
Dokumentation, SDKs und Playground Entwickler können im Browser prototypen, bevor sie Code schreiben; SDKs für mehrere Sprachen senken die EinstiegshürdedokumentiertQuelle (öffnet in neuem Tab)
Vor dem Bezahlen bei fal prüfen
Kein Pauschalabo; die Kosten steigen mit der Nutzung Unberechenbare Monatsrechnungen bei Apps mit hohem Volumen; keine Kostenobergrenze, außer Sie setzen sie selbst durchdokumentiertQuelle (öffnet in neuem Tab)
Richtet sich an Entwickler und erfordert eine API-Integration Nicht-technische Nutzer können fal nicht direkt verwenden; nur für Teams mit Entwicklern geeignetdokumentiertQuelle (öffnet in neuem Tab)
Einige Modelle werden nach GPU-Zeit abgerechnet Die Inferenzkosten bei GPU-intensiven Modellen können höher ausfallen als bei alternativen SaaS-PreisendokumentiertQuelle (öffnet in neuem Tab)
Erfordert ein Konto und einen API-Schlüssel Aufwand bei der Authentifizierung; ohne Registrierung und hinterlegte Zahlungsmethode nicht nutzbardokumentiertQuelle (öffnet in neuem Tab)
So nutzen Sie fal für eine Anwendung für generative Medien mit API-basierten KI-Modellen bauen
fal Dokumentation: Quellen der folgenden Schritte. fal.ai, erfasst Oct 1, 2026
fal einrichten
Legen Sie unter https://fal.ai ein fal-Konto an und bestätigen Sie Ihre E-Mail-Adresse
Erzeugen Sie im Dashboard einen API-Schlüssel (Settings > API Keys)
Installieren Sie das fal-SDK: pip install fal (Python) oder npm install @fal-ai/client (JavaScript)
Beispiel: eine Anwendung für generative Medien mit API-basierten KI-Modellen bauen
Wählen Sie ein Modell aus dem Marketplace (z. B. fal-ai/flux/schnell für Bilder)
Formatieren Sie die Eingabe als JSON: {"prompt": "a sunset over mountains"}
Rufen Sie die API mit dem SDK auf: fal_client.subscribe(model_id, arguments=input)
Ergebnis prüfen und exportieren
Prüfen Sie, ob die Antwort das Feld output_url oder ein Bild-/Video-/Audiofeld enthält
Kontrollieren Sie unter Dashboard > Usage die Kosten und die Anfrageprotokolle
Von unserer Redaktion vorgeschlagener Beispiel-Prompt (keine aufgezeichnete Ausgabe des Produkts)
a sunset over mountains
fal Integrationen und API
fal Dokumentation (Fortsetzung). fal.ai, erfasst Oct 1, 2026
Native Integrationen und Exportformate
Export: Bilder: PNG, JPG, WebP (je nach Modell), Videos: MP4, WebM (je nach Modell), Audio: WAV, MP3, OGG (je nach Modell)
API-Zugang und separate Abrechnung
fal hat laut offizieller Dokumentation keine öffentliche API. REST- und WebSocket-APIs; asynchrones und Echtzeit-Streaming werden unterstützt API-Dokumentation ↗
Datenschutz, Datennutzung und kommerzielle Rechte
Zusammengefasst aus den aktuellen Richtlinien des Anbieters; dies ist keine Rechtsberatung, und das Badge eines Anbieters ersetzt kein unabhängiges Audit.
Wie Ihre Eingaben und Ausgaben verarbeitet werden
Nutzer-Prompts, hochgeladene Dateien und erzeugte Ausgaben werden zur Leistungserbringung und Nutzungserfassung gespeichert
fal kann Ein- und Ausgaben zur Modellverbesserung nutzen; Enterprise-Verträge können dies einschränken
Aufbewahrung gemäß den Servicebedingungen; die genaue Dauer ist im Datenschutzauszug nicht angegeben
Kommerzielle Nutzung und Tarifbeschränkungen
Enterprise-Kunden können die kommerzielle Nutzung ihrer Daten vertraglich einschränken
Enterprise-Verträge ermöglichen Einschränkungen bei Datennutzung und Verarbeitungsorten
fal bietet keine kostenlose Stufe; jede Nutzung wird pro Aufruf berechnet. In der offiziellen Preisdokumentation werden keine Gratis-Credits erwähnt. Quelle (öffnet in neuem Tab)
Kann ich eigene Modelle bereitstellen?
Ja. Mit fal Serverless stellen Sie Python-Code mit fal.App bereit; die Infrastruktur skaliert automatisch. Für Training und Fine-Tuning gibt es Dedicated Compute mit vollem SSH-Zugang. Quelle (öffnet in neuem Tab)
Wie hoch ist die Latenz bei einem typischen API-Aufruf?
Modell-APIs antworten in der Regel in unter einer Sekunde; die Videogenerierung kann je nach Modell und Parametern 5 bis 30 Sekunden dauern. Serverless-Deployments haben nach der ersten Nutzung keine Cold-Start-Verzögerung. Quelle (öffnet in neuem Tab)
Wird Echtzeit-Streaming unterstützt?
Ja. Viele Modelle unterstützen synchrone und asynchrone Warteschlangenaufrufe; für Echtzeit-Inferenz bei ausgewählten Modellen stehen WebSocket-Verbindungen bereit. Quelle (öffnet in neuem Tab)
Kann ich fal bei Sicherheitsanforderungen eines Unternehmens einsetzen?
Ja. Enterprise-Kunden erhalten SOC-2-Type-II-Konformität, SSO, private Endpunkte und vertraglich geregelte Einschränkungen bei der Datenverarbeitung. Quelle (öffnet in neuem Tab)
fal pricingpricing · geprüft Oct 1, 2026 · Model API pricing (video, image, audio, 3D), GPU pricing (H100, H200, B200, B300, RTX PRO 6000), Serverless and compute tiers
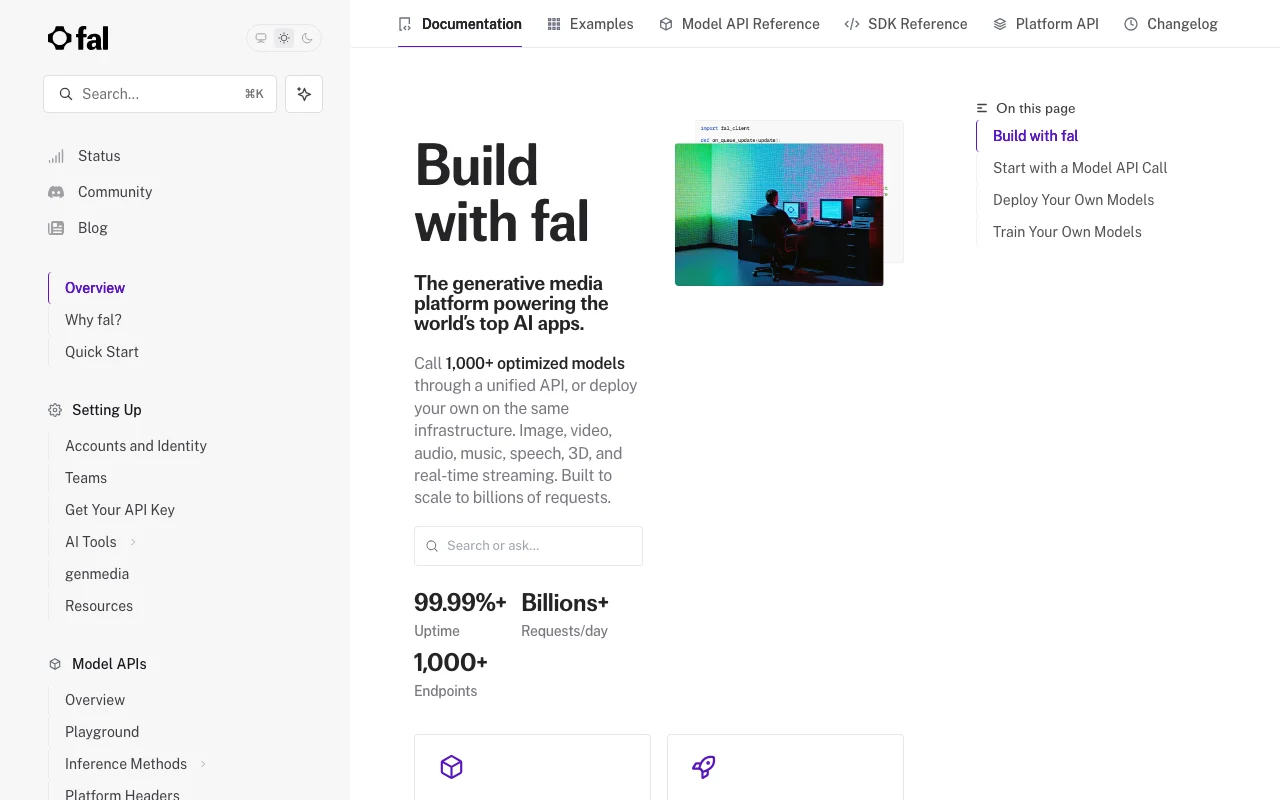
fal documentationdocs · geprüft Oct 1, 2026 · Model API quickstart, Serverless deployment guide, SDK references (Python, JavaScript), Compute provisioning
fal privacy policypolicy · geprüft Oct 1, 2026 · Personal data collection and use, Third-party payment processor, GitHub OAuth option, Enterprise data handling
Nicht verifiziert: free_access: In den offiziellen Unterlagen sind weder eine kostenlose Stufe noch Gratis-Credits erwähnt; trial: Keine Testphase dokumentiert; taxes: Steuerliche Behandlung und Befreiungen nicht angegeben; Aufbewahrungsdauer der Daten: Der genaue Zeitraum ist im Datenschutzauszug nicht genannt; SLA-Details: 99.99 % Verfügbarkeit behauptet; ein formales SLA liegt nicht vor; Export-/Import-Möglichkeiten: Optionen zur Datenübertragbarkeit nicht dokumentiert.
Wie wir diese Seite dokumentiert haben und pflegen
Jede Angabe zu fal oben stammt aus den 4 hier aufgeführten offiziellen Seiten, zuletzt verglichen am Sep 29, 2026; wir haben fal nicht selbst getestet, daher gibt es keine redaktionelle Bewertung. Wie wir Seiten prüfen und erneut prüfen.
Artikel aktualisiert Oct 2, 2026; Preise geprüft Sep 29, 2026. Ausgehende Links zu Anbietern sind einfache Links; wir erhalten keine Provisionen. So testen wir · Fehler melden