Notre avis : Plateforme de médias génératifs à l'usage, avec plus de 1 000 modèles de production et une mise à l'échelle flexible des GPU, idéale pour les développeurs qui créent des fonctionnalités d'IA sans engagement initial.
Principale limite : Pas d'abonnement forfaitaire ; les coûts augmentent avec l'usage
Par la rédaction d'AI Tool Atlas.
D'après la documentation officielle de l'éditeur ; nous n'avons pas testé ce produit en pratique. Ce que signifie « aperçu documenté »
fal est-il fait pour vous ?
Plateforme de médias génératifs à l'usage, avec plus de 1 000 modèles de production et une mise à l'échelle flexible des GPU, idéale pour les développeurs qui créent des fonctionnalités d'IA sans engagement initial. D'après la documentation de l'éditeur, absent d'un test pratique.
Idéal pour : Développeurs qui créent des applications de médias génératifs
Convient aussi pour
Startups d'IA
Équipes de ML qui ont besoin de GPU
Choisissez un autre outil si vous avez besoin d'une tarification forfaitaire
Ou si
Utilisateurs non développeurs qui préfèrent des outils centrés sur l'interface
Vous cherchez uniquement une infrastructure centrée sur l'entraînement
fal dans l'actualité
Titres de médias américains, sélectionnés automatiquement — pas des recommandations. Mis à jour Oct 12, 2026
Pour : Single-GPU development and fine-tuning at lower cost than B300
Limites
Full SSH access
Billed hourly minimum
1 plus
Single-GPU instance
Comprend
80GB VRAM H100 GPU
Full SSH control
2 plus
Persistent storage for code and data
Development and fine-tuning optimized
API incluse
Plafonds d'usage, crédits et coûts supplémentaires
Frais des processeurs de paiement tiers ; des frais de bande passante sortante peuvent s'appliquer pour les sorties volumineuses
Qu'est-ce que fal et comment ça marche ?
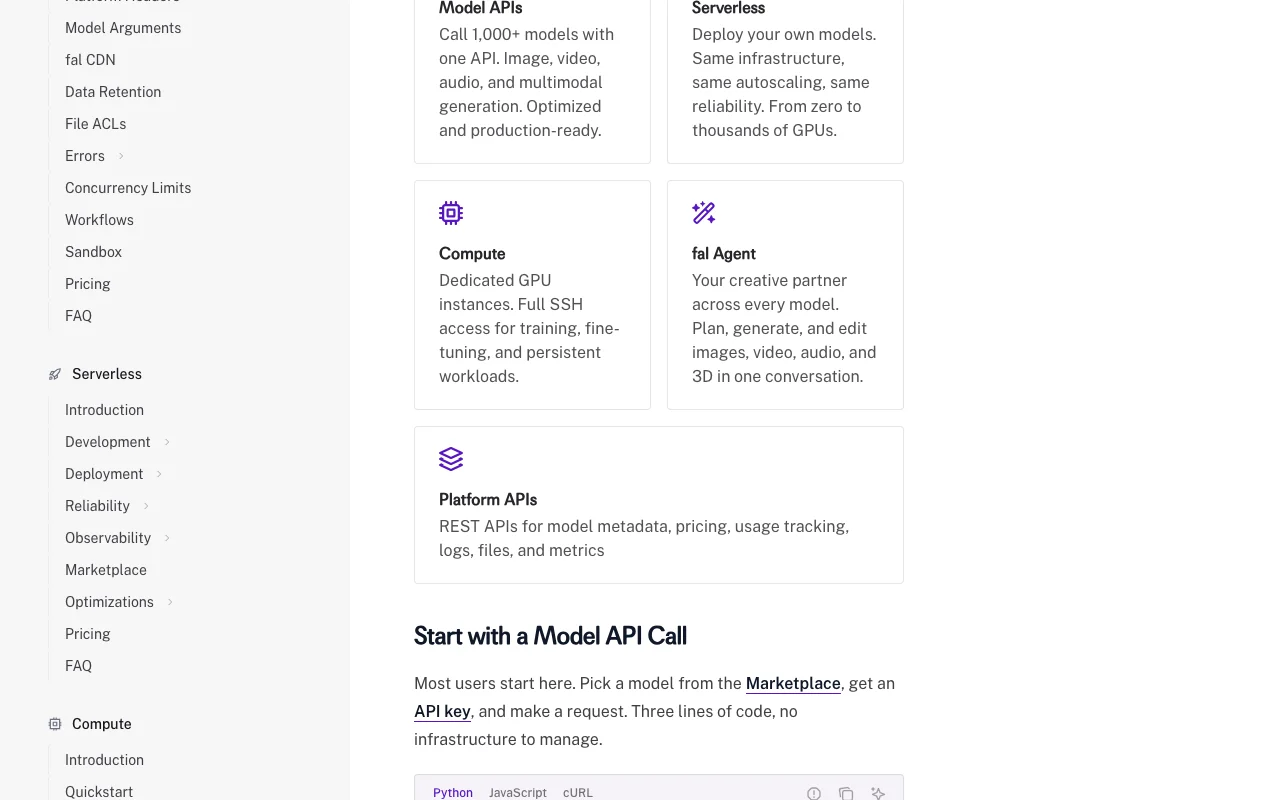
fal est une plateforme de médias génératifs pour développeurs. Elle héberge plus de 1 000 modèles d'image, vidéo, audio et 3D prêts pour la production derrière une API unifiée, y compris des modèles tiers comme FLUX, Veo, Kling et Seedream.
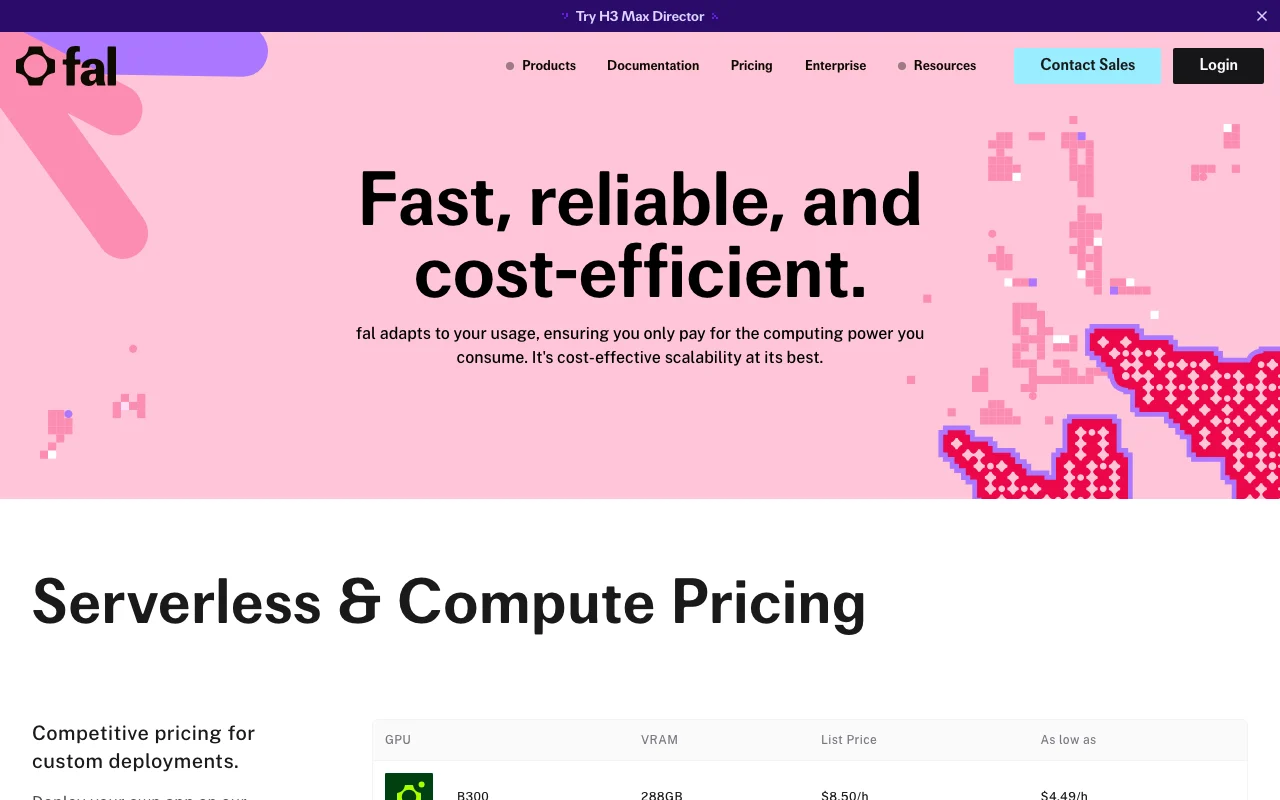
Au-delà des API de modèles, fal propose des déploiements GPU serverless pour des modèles personnalisés ou affinés et des clusters de calcul dédiés pour l'entraînement. La facturation est à l'usage : à la sortie générée pour les API de modèles et à l'heure pour les GPU.
Site officiel de fal : comment le produit se présente. fal.ai, relevé Oct 1, 2026
Ce que vous fournissez et ce que vous obtenez
Ce que vous donnez à fal et ce que vous obtenez, d'après sa documentation
Ce que vous fournissez
Prompts texte
Images ou vidéos de référence
Fichiers audio
Code de modèle personnalisé (pour le déploiement)
Ce que vous obtenez
Images, vidéos, audio et modèles 3D générés
Synthèse vocale et effets sonores
Résultats d'inférence des modèles
Où vous pouvez l'utiliser
Plateformes
Web, API
Compte
Obligatoire
Modèles / versions
1,000+ production-ready models
Meilleurs cas d'usage de fal
Les scénarios sont élaborés par nos éditeurs à partir de la documentation ; le résultat réel dépend de votre saisie et de votre offre.
Ajouter la génération d'images ou de vidéos à une application
Présentation des fonctionnalités sur le site officiel. fal.ai, relevé Oct 1, 2026
API unifiée vers plus de 1 000 modèles génératifs
Achemine un seul appel d'API vers plus de 1 000 modèles d'image, vidéo, audio, musique, 3D et voix Construisez une fois, testez de nombreux modèles sans refondre les intégrations
Accès : API via les SDK fal (Python, JavaScript), REST ou le playground webLimite : La disponibilité et les performances des modèles varient ; certains modèles ont des restrictions régionalessource (s'ouvre dans un nouvel onglet)
Playground web et bac à sable
Interface dans le navigateur pour tester n'importe quel modèle, ajuster les paramètres et comparer les sorties Évaluez les modèles avant de les intégrer, sans écrire de code
Accès : Application web sur fal.ai ; aucune inscription requise pour parcourir, mais l'inférence exige une clé d'APILimite : Le playground est informatif ; les applications de production exigent une intégration APIsource (s'ouvre dans un nouvel onglet)
Déploiements GPU serverless
Déploie du code Python personnalisé avec fal.App ; mise à l'échelle automatique de 0 à plus de 1 000 GPU Exécutez des modèles propriétaires ou affinés sans optimisation de démarrage à froid
Accès : CLI fal (fal deploy) et tableau de bord web ; facturé à la seconde d'exécutionLimite : Python uniquement pour le déploiement ; exige l'abstraction fal.Appsource (s'ouvre dans un nouvel onglet)
Calcul dédié H100/H200/B200/B300
Loue des instances GPU entières avec accès SSH complet pour l'entraînement, l'affinage ou les traitements par lots Exécutez des charges longues à un tarif horaire fixe, sans surcharge de mise à l'échelle automatique
Accès : CLI fal (fal compute create) et tableau de bord ; facturation horaire de l'instance entièreLimite : Nécessite une mise à l'échelle manuelle ; l'heure entière est facturée quel que soit l'usagesource (s'ouvre dans un nouvel onglet)
fal : points forts et limites
Raisons de choisir fal
Vous ne payez que l'usage, avec des prix par sortie publiés Coûts prévisibles pour les petits utilisateurs ; pas de frais cachés ni d'enfermement dans un abonnementdocumentésource (s'ouvre dans un nouvel onglet)
Large choix de modèles d'image, vidéo et audio Les utilisateurs peuvent tester des modèles de pointe comme FLUX, Kling, MiniMax sans changer de plateformedocumentésource (s'ouvre dans un nouvel onglet)
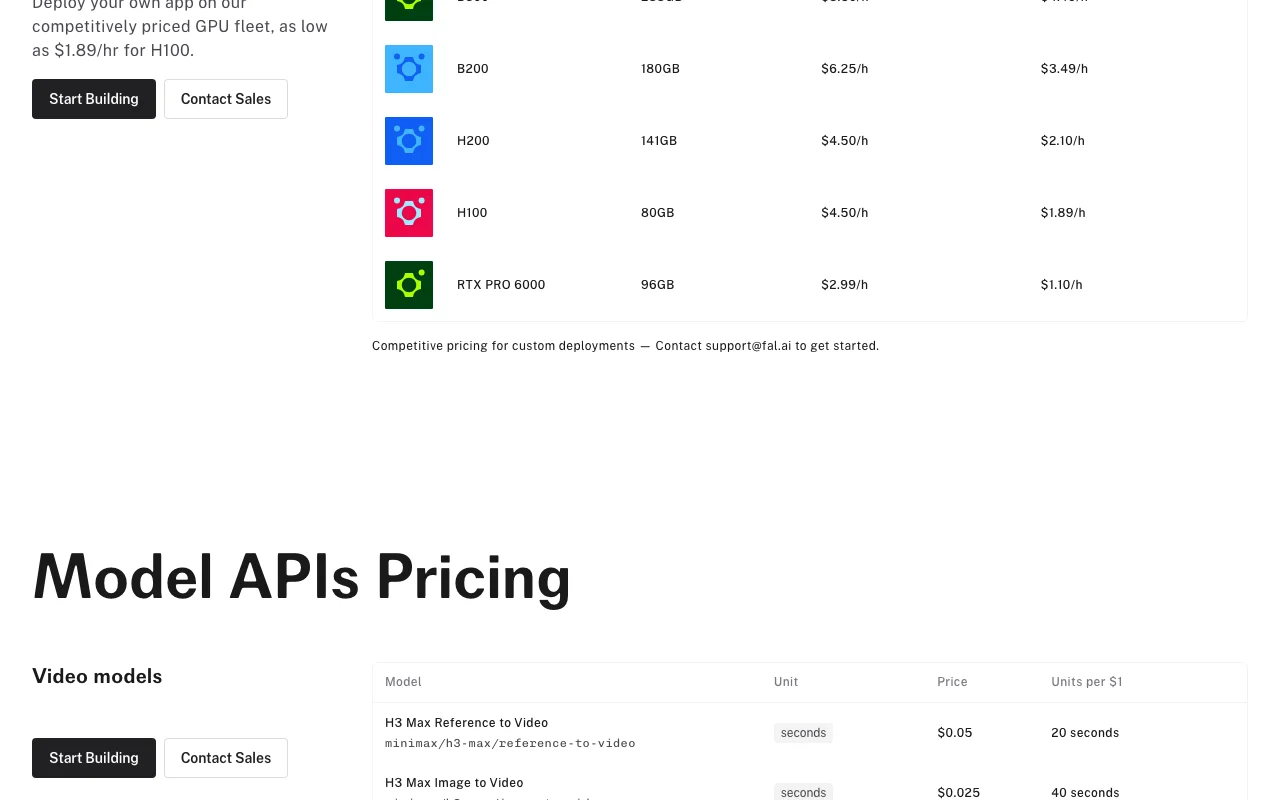
Tarifs GPU publiés (H100 à partir de $1.89/h) Une tarification transparente permet de planifier le budget et de comparer avec les alternativesdocumentésource (s'ouvre dans un nouvel onglet)
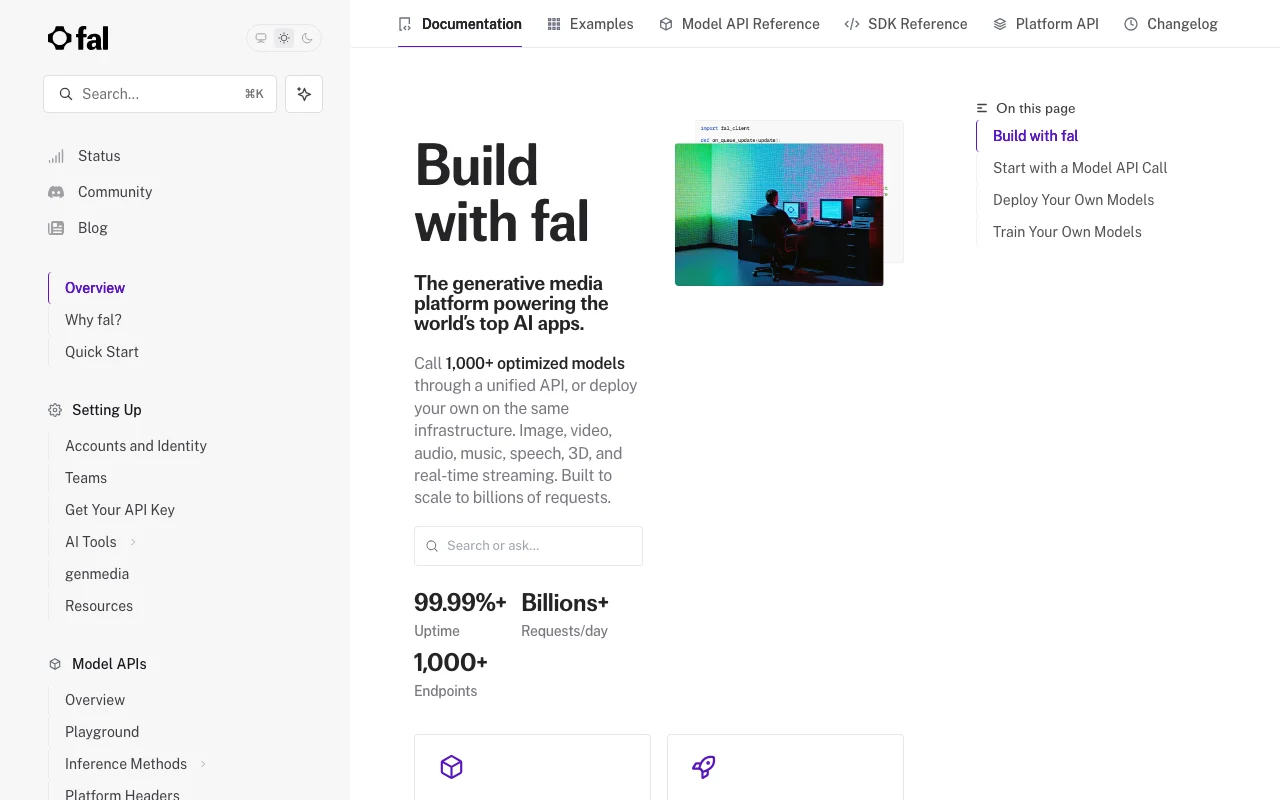
Documentation, SDK et playground Les développeurs peuvent prototyper dans le navigateur avant d'écrire du code ; des SDK dans plusieurs langages réduisent les frictionsdocumentésource (s'ouvre dans un nouvel onglet)
À vérifier avant de payer pour fal
Pas d'abonnement forfaitaire ; les coûts augmentent avec l'usage Factures mensuelles imprévisibles pour les applications à fort volume ; pas de plafond de coût sauf application manuelledocumentésource (s'ouvre dans un nouvel onglet)
Destiné aux développeurs, exige une intégration API Les utilisateurs non techniques ne peuvent pas utiliser fal directement ; adapté uniquement aux équipes disposant d'ingénieursdocumentésource (s'ouvre dans un nouvel onglet)
Certains modèles utilisent une tarification basée sur les GPU Les coûts d'inférence des modèles gourmands en GPU peuvent dépasser les tarifs SaaS alternatifsdocumentésource (s'ouvre dans un nouvel onglet)
Exige un compte et une clé d'API Contrainte d'authentification ; impossible à utiliser sans inscription ni moyen de paiement enregistrédocumentésource (s'ouvre dans un nouvel onglet)
Comment utiliser fal pour créer une application de médias génératifs avec des modèles d'IA accessibles en priorité par API
Documentation fal : d'où viennent les étapes ci-dessous. fal.ai, relevé Oct 1, 2026
Configurer fal
Créez un compte fal sur https://fal.ai et vérifiez votre e-mail
Générez une clé d'API dans le tableau de bord (Settings > API Keys)
Installez le SDK fal : pip install fal (Python) ou npm install @fal-ai/client (JavaScript)
Exemple : créer une application de médias génératifs avec des modèles d'IA accessibles en priorité par API
Sélectionnez un modèle dans la Marketplace (p. ex. fal-ai/flux/schnell pour les images)
Formatez l'entrée en JSON : {"prompt": "a sunset over mountains"}
Appelez l'API avec le SDK : fal_client.subscribe(model_id, arguments=input)
Vérifier et exporter le résultat
Vérifiez que la réponse contient le champ output_url ou image/video/audio
Consultez Dashboard > Usage pour le suivi des coûts et les journaux de requêtes
Exemple de prompt proposé par nos éditeurs (pas une sortie enregistrée du produit)
a sunset over mountains
fal intégrations et API
Documentation fal (suite). fal.ai, relevé Oct 1, 2026
Intégrations natives et formats d'export
Exporter : Images : PNG, JPG, WebP (selon le modèle), Vidéos : MP4, WebM (selon le modèle), Audio : WAV, MP3, OGG (selon le modèle)
Accès à l'API et facturation séparée
fal n'a pas d'API publique dans sa documentation officielle. API REST et WebSocket ; streaming asynchrone et en temps réel pris en charge Documentation de l'API ↗
Confidentialité, usage des données et droits commerciaux
Résumé des politiques actuelles de l'éditeur ; ce n'est pas un avis juridique et le badge d'un éditeur n'est pas un audit indépendant.
Comment vos entrées et sorties sont traitées
Les prompts, fichiers importés et sorties générées sont stockés pour la fourniture du service et le suivi de l'usage
fal peut utiliser les entrées/sorties pour améliorer ses modèles ; les contrats Enterprise peuvent restreindre cet usage
Conservées selon les conditions du service ; durée exacte non précisée dans l'extrait de la politique de confidentialité
Usage commercial et restrictions des offres
Les clients Enterprise peuvent restreindre par contrat l'usage commercial de leurs données
Des contrats Enterprise sont disponibles pour restreindre l'utilisation des données et les lieux de traitement
fal ne propose pas d'offre gratuite ; tout l'usage est facturé à l'appel. Aucun crédit gratuit n'est mentionné dans la documentation officielle des tarifs. source (s'ouvre dans un nouvel onglet)
Puis-je déployer mes propres modèles personnalisés ?
Oui. Utilisez fal Serverless pour déployer du code Python avec fal.App ; l'infrastructure s'adapte automatiquement. Le calcul dédié est disponible pour l'entraînement et l'affinage avec un accès SSH complet. source (s'ouvre dans un nouvel onglet)
Quelle est la latence d'un appel d'API typique ?
Les API de modèles répondent généralement en moins d'une seconde ; la génération vidéo peut prendre de 5 à 30 secondes selon le modèle et les paramètres. Les déploiements serverless n'ont aucune pénalité de démarrage à froid après la première utilisation. source (s'ouvre dans un nouvel onglet)
Prenez-vous en charge le streaming en temps réel ?
Oui. De nombreux modèles prennent en charge les appels synchrones et par file asynchrone ; des connexions WebSocket sont disponibles pour l'inférence en temps réel sur certains modèles. source (s'ouvre dans un nouvel onglet)
Puis-je utiliser fal avec des exigences de sécurité d'entreprise ?
Oui. Les clients Enterprise bénéficient de la conformité SOC 2 Type II, du SSO, de points de terminaison privés et de restrictions contractuelles sur le traitement des données. source (s'ouvre dans un nouvel onglet)
fal pricingpricing · vérifié Oct 1, 2026 · Model API pricing (video, image, audio, 3D), GPU pricing (H100, H200, B200, B300, RTX PRO 6000), Serverless and compute tiers
fal documentationdocs · vérifié Oct 1, 2026 · Model API quickstart, Serverless deployment guide, SDK references (Python, JavaScript), Compute provisioning
fal privacy policypolicy · vérifié Oct 1, 2026 · Personal data collection and use, Third-party payment processor, GitHub OAuth option, Enterprise data handling
Non vérifié : free_access : aucune offre gratuite ni crédit gratuit mentionné dans les documents officiels; trial : aucune période d'essai documentée; taxes : traitement fiscal et exonérations non précisés; Durée de conservation des données : fenêtre exacte non indiquée dans l'extrait de la politique de confidentialité; Détails du SLA : disponibilité de 99,99 % annoncée ; SLA formel non fourni; Capacités d'export/import : options de portabilité des données non documentées.
Comment nous avons documenté et maintenons cette page
Chaque information sur fal ci-dessus provient des 4 pages officiels listés ici, comparés pour la dernière fois le Sep 29, 2026 ; nous n'avons pas testé fal nous-mêmes, il n'a donc pas de note éditoriale. Comment nous vérifions et revérifions les pages.
Article mis à jour Oct 2, 2026; prix vérifiés Sep 29, 2026. Les liens sortants vers les éditeurs sont de simples liens ; nous ne touchons aucune commission. Comment nous évaluons · Signaler une erreur