Nossa opinião: Plataforma de mídia generativa com pagamento por uso, mais de 1,000 modelos em produção e escala flexível de GPU, ideal para desenvolvedores que criam recursos de IA sem compromisso inicial.
Principal limitação: Sem assinatura fixa; os custos crescem conforme o uso
Pela equipe editorial do AI Tool Atlas.
Com base na documentação oficial do fornecedor; não testamos este produto na prática. O que “visão geral documentada” significa
O fal é para você?
Plataforma de mídia generativa com pagamento por uso, mais de 1,000 modelos em produção e escala flexível de GPU, ideal para desenvolvedores que criam recursos de IA sem compromisso inicial. Com base na documentação do fornecedor, fora de um teste prático.
Ideal para: Desenvolvedores que criam apps de mídia generativa
Também indicado para
Startups de IA
Equipes de ML que precisam de GPUs
Considere outra ferramenta se precisa de preço fixo
Ou se
Usuários não desenvolvedores que preferem ferramentas centradas na interface
Busca apenas infraestrutura voltada a treinamento
fal nas notícias
Manchetes de veículos dos EUA, selecionadas automaticamente. Não são recomendações. Atualizado Oct 12, 2026
Para: Single-GPU development and fine-tuning at lower cost than B300
Limites
Full SSH access
Billed hourly minimum
1 mais
Single-GPU instance
Inclui
80GB VRAM H100 GPU
Full SSH control
2 mais
Persistent storage for code and data
Development and fine-tuning optimized
API incluída
Limites de uso, créditos e custos extras
Taxas de processadores de pagamento de terceiros; podem ser cobradas tarifas de banda de saída para resultados grandes
O que é fal e como funciona?
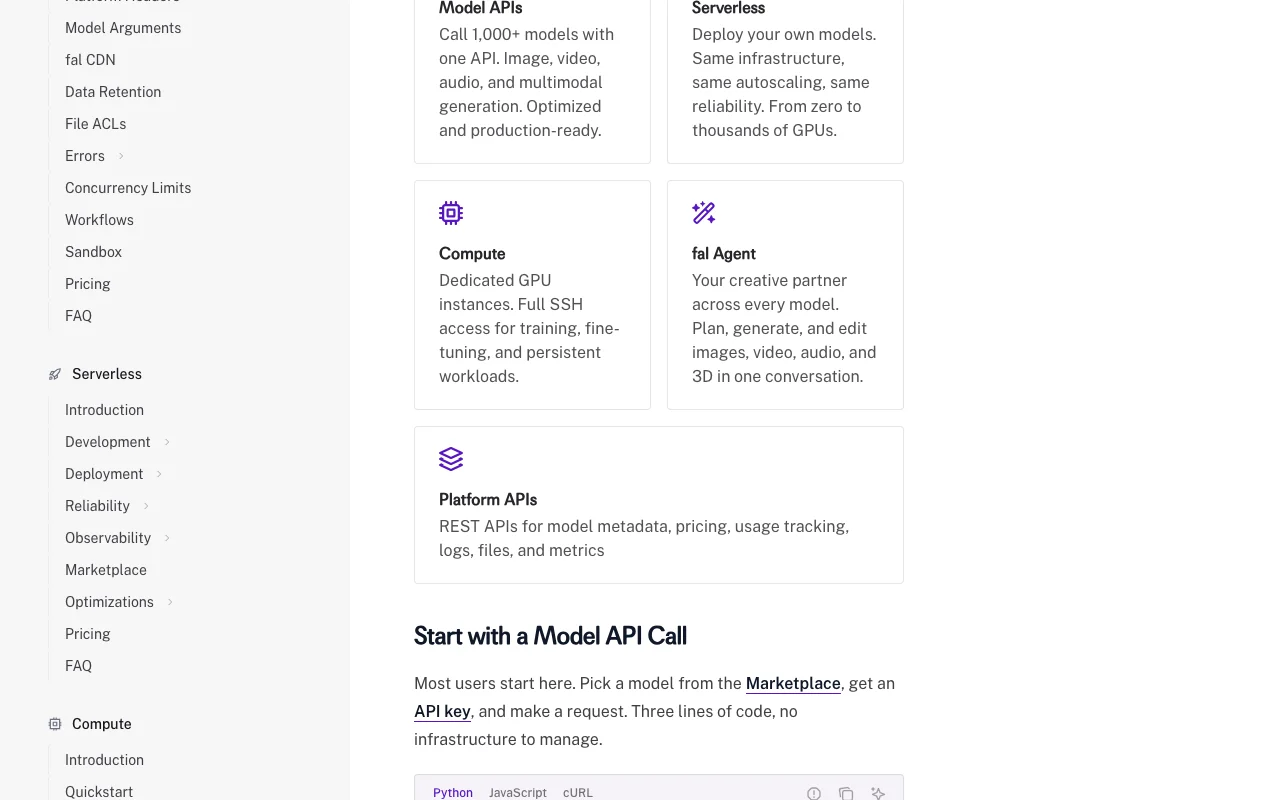
A fal é uma plataforma de mídia generativa para desenvolvedores. Ela hospeda mais de 1,000 modelos de imagem, vídeo, áudio e 3D prontos para produção por trás de uma API unificada, incluindo modelos de terceiros como FLUX, Veo, Kling e Seedream.
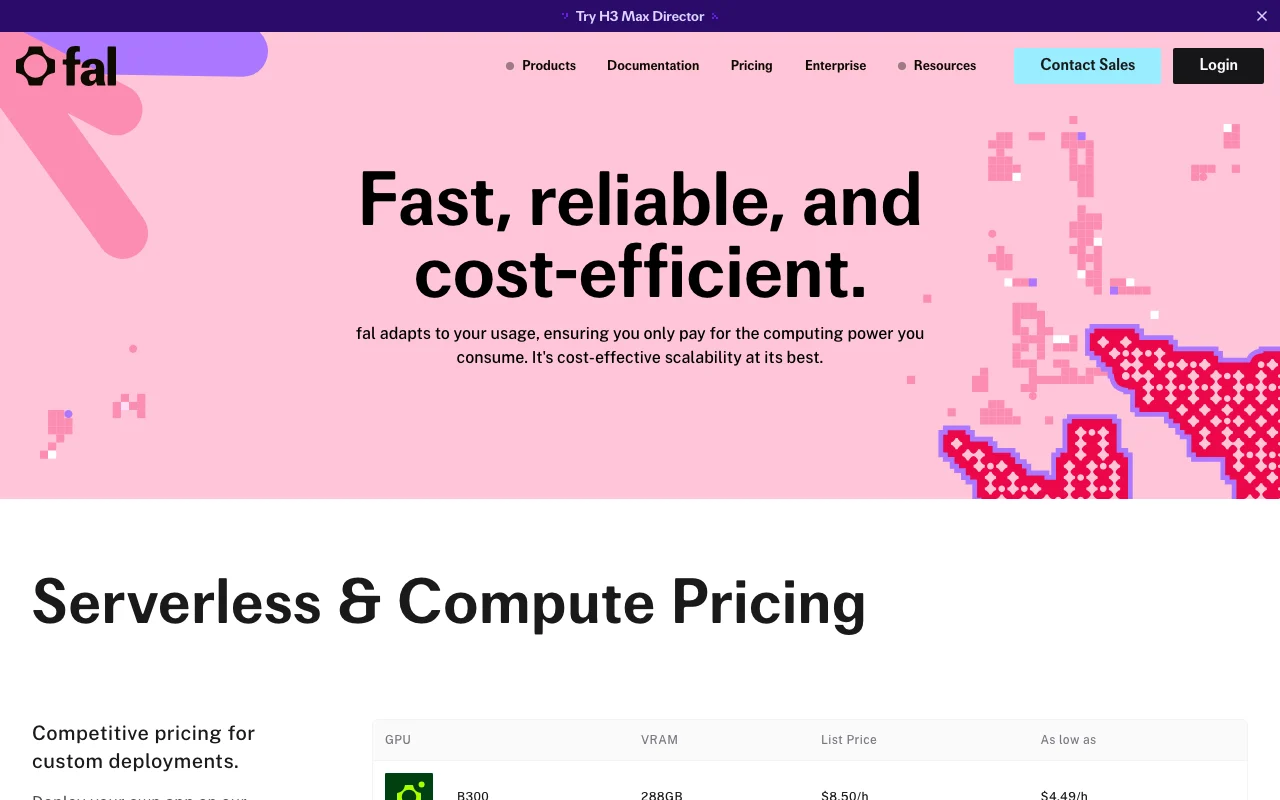
Além das APIs de modelos, a fal oferece implantações de GPU serverless para modelos personalizados ou ajustados e clusters de computação dedicados para treinamento. A cobrança é por uso: por resultado nas APIs de modelos e por hora nas GPUs.
Site oficial do fal: como o produto se apresenta. fal.ai, capturado Oct 1, 2026
O que você fornece e o que recebe de volta
O que você fornece a fal e o que recebe de volta, segundo a documentação
O que você fornece
Prompts de texto
Imagens ou vídeos de referência
Arquivos de áudio
Código de modelo personalizado (para implantação)
O que você recebe de volta
Imagens, vídeos, áudio e modelos 3D gerados
Síntese de fala e efeitos sonoros
Resultados de inferência de modelos
Onde você pode usar
Plataformas
Web, API
Conta
Obrigatório
Modelos / versões
Mais de 1,000 modelos prontos para produção
Melhores casos de uso do fal
Os cenários são elaborados por nossos editores a partir da documentação; o resultado real depende da sua entrada e do seu plano.
Visão geral dos recursos no site oficial. fal.ai, capturado Oct 1, 2026
API unificada para mais de 1,000 modelos generativos
Direciona uma única chamada de API a mais de 1,000 modelos de imagem, vídeo, áudio, música, 3D e fala Crie uma vez e teste vários modelos sem refazer as integrações
Acesso: API pelos SDKs da fal (Python, JavaScript), REST ou playground na webLimite: A disponibilidade e o desempenho dos modelos variam; alguns têm restrições regionaisfonte (abre em uma nova guia)
Playground e sandbox na web
Interface no navegador para testar qualquer modelo, ajustar parâmetros e comparar resultados Avalie os modelos antes de integrar, sem escrever código
Acesso: App web em fal.ai; não exige cadastro para navegar, mas a inferência exige chave de APILimite: O playground é só informativo; apps em produção exigem integração por APIfonte (abre em uma nova guia)
Implantações de GPU serverless
Implante código Python personalizado com fal.App; escala automaticamente de 0 a mais de 1000 GPUs Execute modelos proprietários ou ajustados com otimização de cold start zero
Acesso: CLI da fal (fal deploy) e painel web; cobrança por segundo de execuçãoLimite: Implantação somente em Python; exige a abstração fal.Appfonte (abre em uma nova guia)
Computação dedicada H100/H200/B200/B300
Alugue instâncias de GPU inteiras com acesso SSH completo para treinamento, ajuste fino ou jobs em lote Execute cargas de longa duração a uma taxa horária fixa, sem a sobrecarga do escalonamento automático
Acesso: CLI da fal (fal compute create) e painel; cobrança por hora da instância completaLimite: Exige escalonamento manual; a hora cheia é cobrada independentemente do usofonte (abre em uma nova guia)
fal: pontos fortes e limites
Motivos para escolher fal
Pague apenas pelo uso, com preços por resultado publicados Custos previsíveis para quem usa pouco; sem taxas ocultas nem assinatura obrigatóriadocumentadofonte (abre em uma nova guia)
Ampla escolha de modelos de imagem, vídeo e áudio Os usuários podem experimentar modelos de ponta como FLUX, Kling e MiniMax sem trocar de plataformadocumentadofonte (abre em uma nova guia)
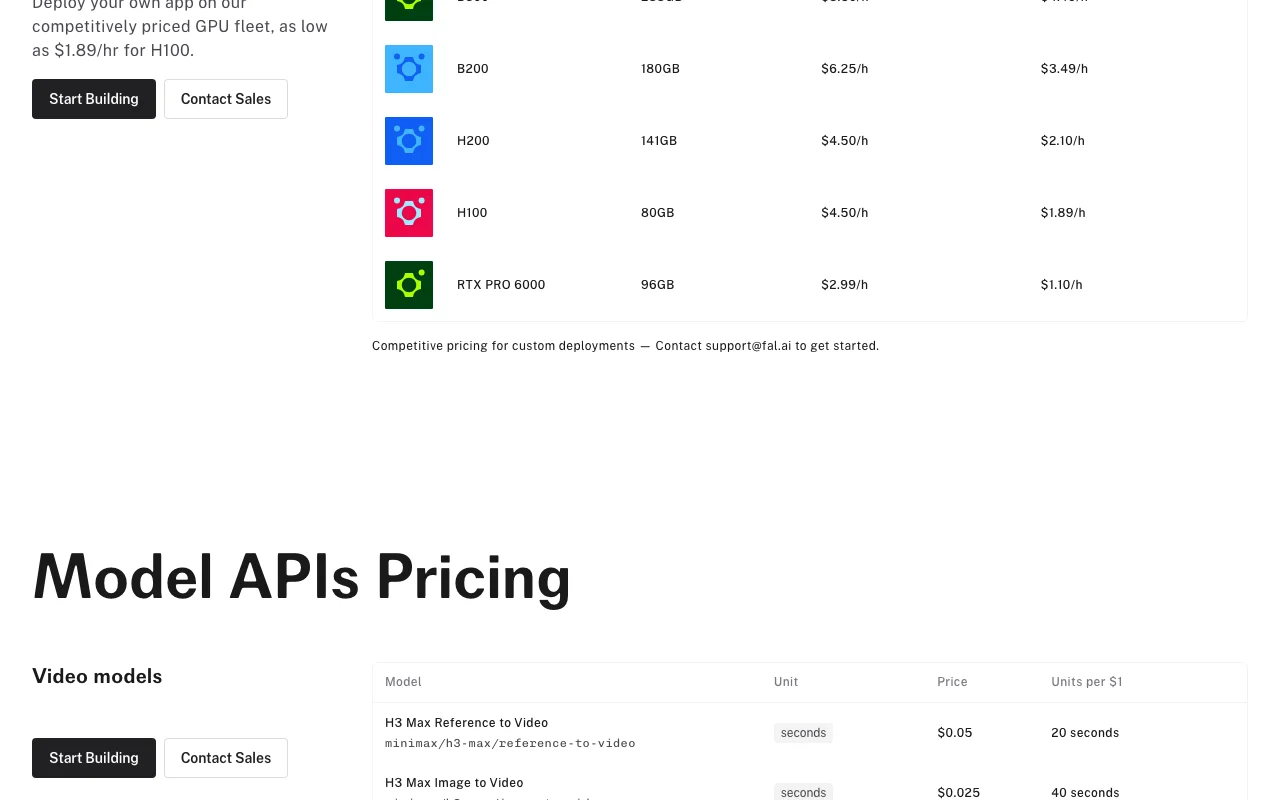
Tarifas de GPU divulgadas publicamente (H100 a partir de $1.89/h) Preços transparentes facilitam o planejamento do orçamento e a comparação com alternativasdocumentadofonte (abre em uma nova guia)
Documentação, SDKs e playground Os desenvolvedores podem prototipar no navegador antes de escrever código; SDKs em várias linguagens reduzem o atritodocumentadofonte (abre em uma nova guia)
Confira antes de pagar pelo fal
Sem assinatura fixa; os custos crescem conforme o uso Faturas mensais imprevisíveis em apps de alto volume; sem teto de custo, a menos que seja aplicado manualmentedocumentadofonte (abre em uma nova guia)
Voltada a desenvolvedores, exige integração por API Usuários não técnicos não conseguem usar a fal diretamente; serve apenas para equipes com engenhariadocumentadofonte (abre em uma nova guia)
Alguns modelos usam preço baseado em GPU Os custos de inferência de modelos que exigem muita GPU podem superar os preços de SaaS alternativosdocumentadofonte (abre em uma nova guia)
Exige conta e chave de API Etapa extra de autenticação; não dá para usar sem cadastro e sem forma de pagamento registradadocumentadofonte (abre em uma nova guia)
Como usar o fal para criar um app de mídia generativa com modelos de IA baseados em API
Documentação do fal: de onde vêm os passos abaixo. fal.ai, capturado Oct 1, 2026
Configurar fal
Crie uma conta na fal em https://fal.ai e confirme o e-mail
Gere uma chave de API no painel (Settings > API Keys)
Instale o SDK da fal: pip install fal (Python) ou npm install @fal-ai/client (JavaScript)
Exemplo: criar um app de mídia generativa com modelos de IA baseados em API
Escolha um modelo no Marketplace (por exemplo, fal-ai/flux/schnell para imagens)
Formate a entrada como JSON: {"prompt": "a sunset over mountains"}
Chame a API com o SDK: fal_client.subscribe(model_id, arguments=input)
Revise e exporte o resultado
Verifique se a resposta contém o campo output_url ou o campo de imagem/vídeo/áudio
Confira Dashboard > Usage para acompanhar custos e logs de requisições
Exemplo de prompt sugerido por nossos editores (não é uma saída registrada do produto)
a sunset over mountains
fal integrações e API
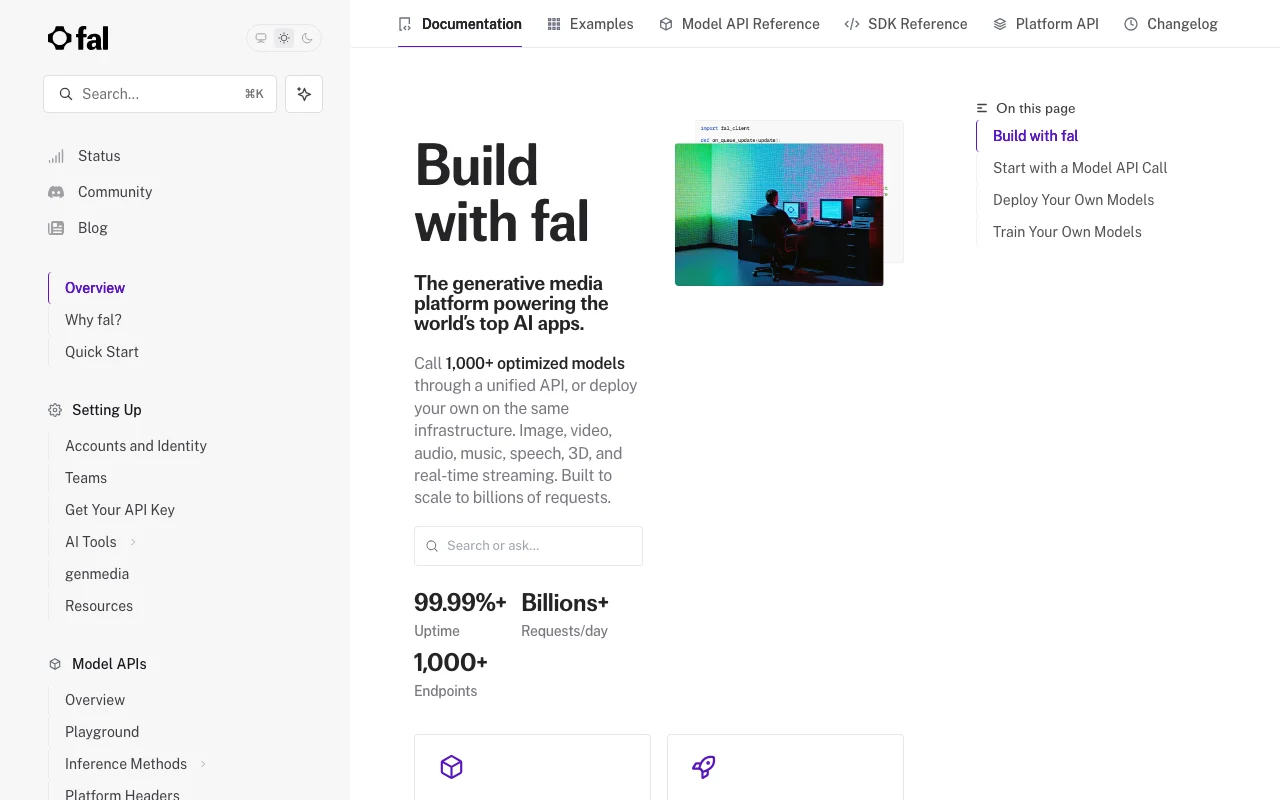
Documentação do fal (continuação). fal.ai, capturado Oct 1, 2026
Integrações nativas e formatos de exportação
Exportar: Imagens: PNG, JPG, WebP (conforme o modelo), Vídeos: MP4, WebM (varia conforme o modelo), Áudio: WAV, MP3, OGG (varia conforme o modelo)
Acesso à API e cobrança separada
fal não tem API pública na documentação oficial. APIs REST e WebSocket; suporte a streaming assíncrono e em tempo real Documentação da API ↗
Privacidade, uso de dados e direitos comerciais
Resumido a partir das políticas atuais do fornecedor; não é aconselhamento jurídico, e o selo de um fornecedor não é uma auditoria independente.
Como suas entradas e saídas são tratadas
Prompts do usuário, arquivos enviados e resultados gerados são armazenados para prestação do serviço e acompanhamento de uso
A fal pode usar entradas e saídas para melhorar modelos; contratos Enterprise podem restringir isso
Retidos conforme os termos do serviço; o período exato não é especificado no trecho da política de privacidade
Uso comercial e restrições de plano
Clientes Enterprise podem restringir por contrato o uso comercial de seus dados
Contratos Enterprise permitem restringir o uso de dados e os locais de processamento
A fal não oferece plano gratuito; todo o uso é pago por chamada. A documentação oficial de preços não menciona créditos gratuitos. fonte (abre em uma nova guia)
Sim. Use o fal Serverless para implantar código Python com fal.App; a infraestrutura escala automaticamente. A computação dedicada está disponível para treinamento e ajuste fino, com acesso SSH completo. fonte (abre em uma nova guia)
Qual é a latência de uma chamada de API típica?
As APIs de modelos normalmente respondem em menos de um segundo; a geração de vídeo pode levar de 5 a 30 segundos, conforme o modelo e os parâmetros. As implantações serverless não têm penalidade de cold start após o primeiro uso. fonte (abre em uma nova guia)
Vocês oferecem suporte a streaming em tempo real?
Sim. Muitos modelos aceitam chamadas síncronas e em fila assíncrona; há conexões WebSocket para inferência em tempo real em alguns modelos. fonte (abre em uma nova guia)
Posso usar a fal com requisitos de segurança corporativos?
Sim. Clientes Enterprise têm conformidade SOC 2 Type II, SSO, endpoints privados e restrições contratuais de tratamento de dados. fonte (abre em uma nova guia)
fal pricingpricing · verificado Oct 1, 2026 · Model API pricing (video, image, audio, 3D), GPU pricing (H100, H200, B200, B300, RTX PRO 6000), Serverless and compute tiers
fal documentationdocs · verificado Oct 1, 2026 · Model API quickstart, Serverless deployment guide, SDK references (Python, JavaScript), Compute provisioning
fal privacy policypolicy · verificado Oct 1, 2026 · Personal data collection and use, Third-party payment processor, GitHub OAuth option, Enterprise data handling
Não verificado: free_access: nenhum plano gratuito ou crédito gratuito mencionado nos materiais oficiais; trial: nenhum período de teste documentado; taxes: tratamento de impostos e isenções não especificado; Período de retenção de dados: a janela exata de retenção não consta no trecho da política de privacidade; Detalhes do SLA: 99.99% de uptime declarado; SLA formal não fornecido; Capacidades de exportação/importação: opções de portabilidade de dados não documentadas.
Como documentamos e mantemos esta página
Todos os fatos sobre fal acima vêm de 4 páginas oficiais listados aqui, comparados pela última vez em Sep 29, 2026; não executamos fal por conta própria, por isso ele não tem nota editorial. Como verificamos e reverificamos as páginas.
Artigo atualizado em Oct 2, 2026; preços verificados Sep 29, 2026. Os links para fornecedores são links comuns; não ganhamos comissões. Como avaliamos · Relatar um erro