Preços da fal em 2026: Model APIs, Serverless GPU e Dedicated Compute explicados
Plataforma de mídia generativa com pagamento por uso, mais de 1,000 modelos em produção e escala flexível de GPU, ideal para desenvolvedores que criam recursos de IA sem compromisso inicial.
Starting price
$1.89 (Dedicated Compute (H100))
Free option
No
Plans
4
Prices checked
Sep 29, 2026
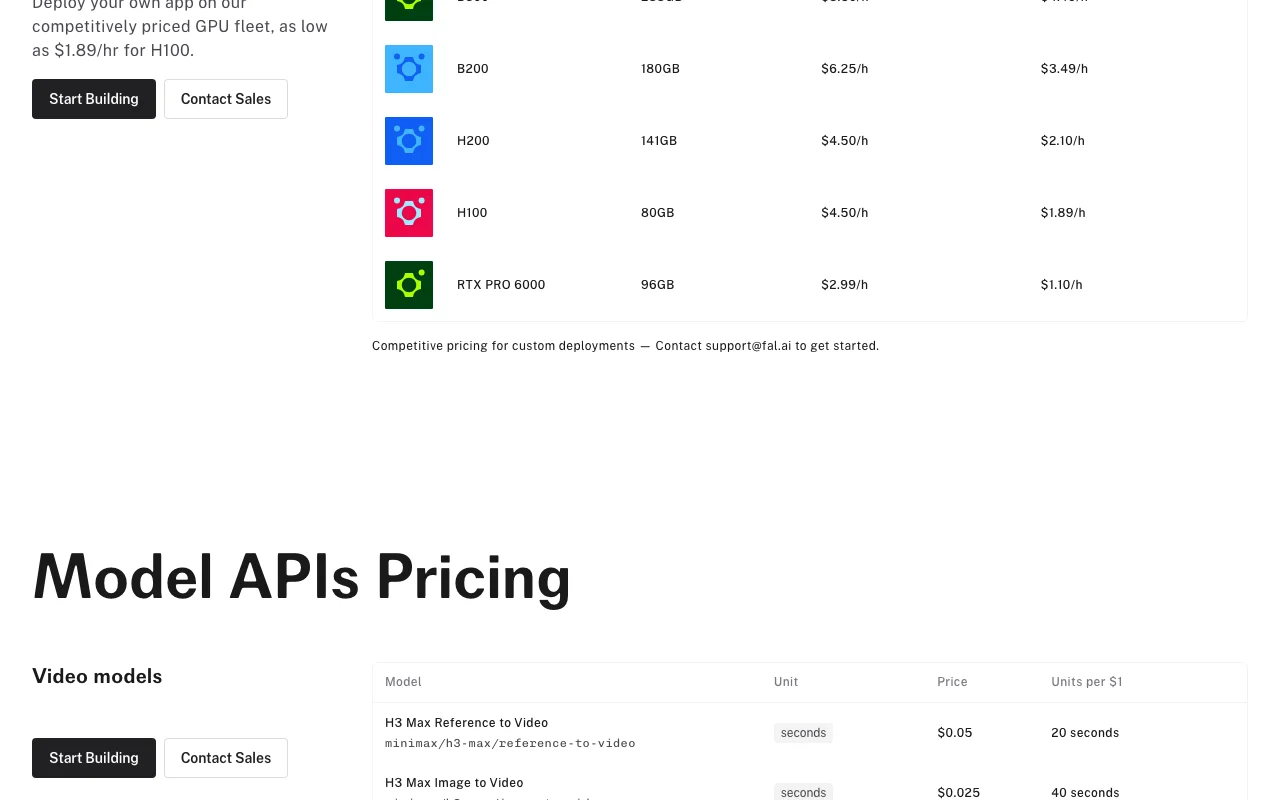
Dedicated Compute (B300)$4.49
Dedicated Compute (H100)$1.89
fal pricing page, captured
Our own captures of each vendor's public pages. Click a frame for the full-size image.
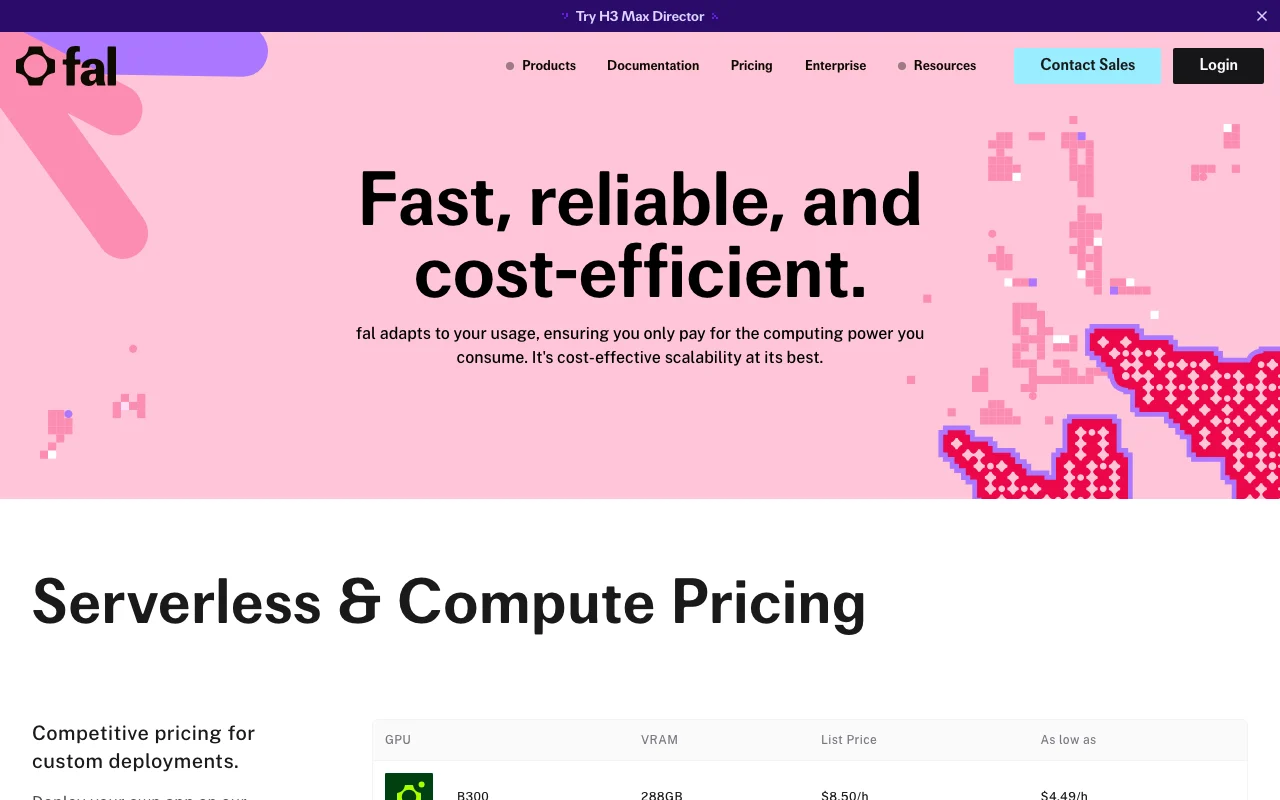
fal plans as listed on its pricing page. fal.ai, capturado Oct 1, 2026More of the fal pricing page. fal.ai, capturado Oct 1, 2026fal homepage. fal.ai, capturado Oct 1, 2026
Planos da fal e o que incluem
A fal não tem níveis de assinatura. Você escolhe como consumir e paga pelo que usar, sem gasto mínimo nem compromisso. As Model APIs são cobradas por resultado, de $0.0002 a $1.00 conforme o modelo e o que ele produz (duração do vídeo, resolução da imagem), com mais de 1,000 modelos de vídeo, imagem, áudio e 3D, sem limites mensais nem por chamada.
Para seus próprios modelos, há GPUs. A Serverless H100 custa $1.89 por hora, é cobrada por segundo de execução e custa $0 quando está ociosa, escalando de 0 a milhares de GPUs. A Dedicated Compute é cobrada pela hora cheia: H100 (80GB) a $1.89 por hora e B300 (288GB de VRAM) a $4.49 por hora, ambas com acesso SSH completo. Descontos por volume e compromissos anuais são tratados com o time de vendas. Preços verificados em 2026-09-29.
fal plans compared
Plans and prices
Plan
Price
Billing
Who it is for
Key limits
API
Model APIs (Pay-Per-Use) API
Cobrança por uso
Per API call
Building generative media features with minimal fixed overhead
No per-month or per-API-call caps; 1,000+ models available; Pricing varies by model and output type (e.g., video duration, image resolution)
Included
Serverless GPU (H100) API
$1.89 per hour (billed per second of execution)
Hourly + per-second execution
Deploying custom or fine-tuned models with automatic scaling
Auto-scales from 0 to 1,000s of GPUs; Billed per-second when running; $0 when idle; Minimum execution ~1 second per request
Included
Dedicated Compute (B300) API
$4.49 per hour (288GB VRAM)
Hourly
Training, fine-tuning, and sustained compute workloads with guaranteed performance
Full SSH access (no autoscaling); Billed for full hour regardless of usage; Dedicated instance (no sharing)
Included
Dedicated Compute (H100) API
$1.89 per hour (80GB VRAM)
Hourly
Single-GPU development and fine-tuning at lower cost than B300
Full SSH access; Billed hourly minimum; Single-GPU instance
Included
Which fal plan to pick
Which plan to pick
If you
Pick
Why
você quer adicionar geração de imagem, vídeo ou áudio a um app sem gasto inicial
Model APIs (pagamento por uso)
Sem mínimo nem compromisso; o preço por resultado varia de $0.0002 a $1.00 conforme o modelo.
você faz deploy de um modelo próprio ou ajustado e o tráfego é irregular
Serverless GPU (H100), $1.89/h
Cobrança por segundo de execução, $0 quando ociosa, escala automática a partir de 0, com deploy de modelos privados.
você treina ou ajusta modelos em uma única GPU
Dedicated Compute (H100), $1.89/h
80GB de VRAM, acesso SSH completo e armazenamento persistente; cobrança por hora com um mínimo.
você roda cargas de treinamento pesadas e contínuas
Dedicated Compute (B300), $4.49/h
288GB de VRAM, InfiniBand para configurações multi-GPU e disponibilidade em várias regiões. Cobra-se a hora cheia, independentemente do uso.
What is free, what costs extra
Free access and trial
The vendor does not describe a free tier on the pages we read.
Extra costs and taxes
Taxas de processadores de pagamento de terceiros; podem ser cobradas tarifas de banda de saída para resultados grandes
Costs that are easy to miss
Não há assinatura fixa nem teto de custo, a menos que você mesmo o imponha. Por isso a fatura cresce com o uso e pode ser imprevisível em volumes altos.
Alguns modelos usam preço baseado em GPU, então a inferência de modelos que exigem muita GPU pode custar mais do que alternativas SaaS.
Valem as taxas de processadores de pagamento de terceiros, e podem ser cobradas tarifas de largura de banda de saída para resultados grandes.
É preciso ter uma conta, uma chave de API e um método de pagamento cadastrado antes de usar.
Preços e limites de uso do fal
Preços verificados em Sep 29, 2026 na página oficial de preços dos EUA. Preços oficiais ↗ Preços e limites mudam com frequência.
Página de preços do fornecedor verificada novamente de forma automática em há 15 dias: nenhuma mudança detectada.
Para: Single-GPU development and fine-tuning at lower cost than B300
Limites
Full SSH access
Billed hourly minimum
1 mais
Single-GPU instance
Inclui
80GB VRAM H100 GPU
Full SSH control
2 mais
Persistent storage for code and data
Development and fine-tuning optimized
API incluída
Limites de uso, créditos e custos extras
Taxas de processadores de pagamento de terceiros; podem ser cobradas tarifas de banda de saída para resultados grandes
How much fal costs per year
At the listed prices, a single user pays between $23 and $54 a year on the fixed-price plans. Annual billing discounts, taxes and usage-based extras are listed per plan above where the vendor publishes them.
Perguntas frequentes sobre fal
O que está incluído no plano gratuito?
A fal não oferece plano gratuito; todo o uso é pago por chamada. A documentação oficial de preços não menciona créditos gratuitos. fonte (abre em uma nova guia)
Sim. Use o fal Serverless para implantar código Python com fal.App; a infraestrutura escala automaticamente. A computação dedicada está disponível para treinamento e ajuste fino, com acesso SSH completo. fonte (abre em uma nova guia)
Qual é a latência de uma chamada de API típica?
As APIs de modelos normalmente respondem em menos de um segundo; a geração de vídeo pode levar de 5 a 30 segundos, conforme o modelo e os parâmetros. As implantações serverless não têm penalidade de cold start após o primeiro uso. fonte (abre em uma nova guia)
A fal tem plano gratuito?
Nossos dados verificados não indicam plano gratuito nem teste. As Model APIs não têm gasto mínimo nem compromisso, mas você precisa de uma conta e de um método de pagamento.
Quanto a fal cobra por imagem ou vídeo?
Varia conforme o modelo e o resultado, de $0.0002 a $1.00 por resultado. A duração do vídeo e a resolução da imagem afetam o preço.
Quanto custa uma H100 na fal?
$1.89 por hora, tanto na serverless (cobrada por segundo de execução) quanto na dedicada (cobrada por hora).
Qual é a diferença entre serverless e dedicated compute?
A serverless escala automaticamente e cobra só enquanto está rodando. A dedicated dá uma instância completa com acesso SSH, cobrada pela hora cheia, independentemente do uso.
Posso conseguir desconto no compute da fal?
Há descontos por volume e compromissos anuais, disponíveis falando com o time de vendas.
More about fal
Full fal guide: features, use cases, how-to and sources.