Nuestra opinión: Plataforma de medios generativos de pago por uso con más de 1,000 modelos en producción y escalado flexible de GPU, ideal para desarrolladores que crean funciones de IA sin compromisos iniciales.
Limitación principal: Sin suscripción fija; los costos escalan con el uso
Por los editores de AI Tool Atlas.
Basado en la documentación oficial del proveedor; no hemos probado este producto en la práctica. Qué significa “resumen documentado”
¿fal es para ti?
Plataforma de medios generativos de pago por uso con más de 1,000 modelos en producción y escalado flexible de GPU, ideal para desarrolladores que crean funciones de IA sin compromisos iniciales. Basado en la documentación del proveedor, sin prueba práctica.
Ideal para: Desarrolladores que crean aplicaciones de medios generativos
También encaja bien en
Startups de IA
Equipos de ML que necesitan GPUs
Considera otra herramienta si necesitas precios de tarifa plana
O si
Usuarios no desarrolladores que prefieren herramientas centradas en la interfaz
Buscas solo infraestructura orientada al entrenamiento
fal en las noticias
Titulares de medios de EE. UU., seleccionados automáticamente; no son recomendaciones. Actualizado Oct 12, 2026
Para: Single-GPU development and fine-tuning at lower cost than B300
Límites
Full SSH access
Billed hourly minimum
1 más
Single-GPU instance
Incluye
80GB VRAM H100 GPU
Full SSH control
2 más
Persistent storage for code and data
Development and fine-tuning optimized
API incluida
Límites de uso, créditos y costos adicionales
Comisiones de procesadores de pago de terceros; pueden aplicarse cargos por ancho de banda de salida en resultados grandes
¿Qué es fal y cómo funciona?
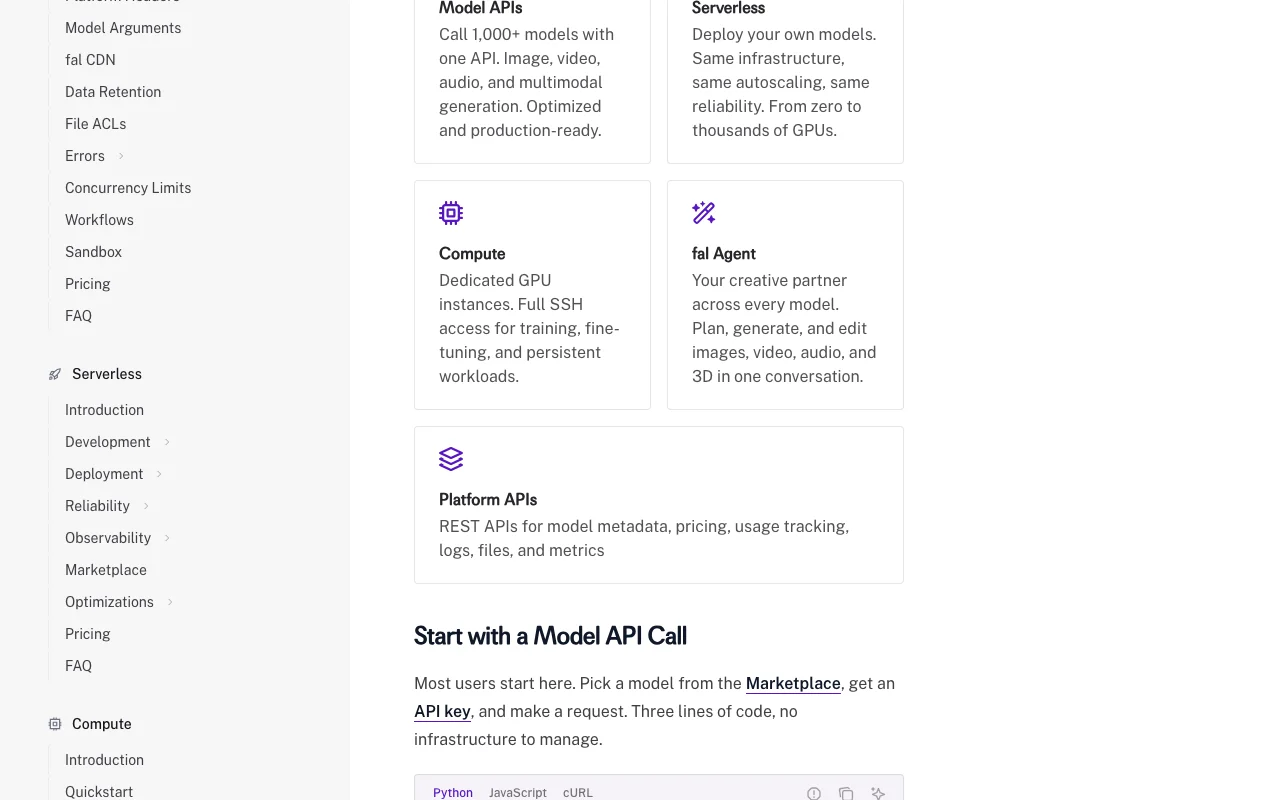
fal es una plataforma de medios generativos para desarrolladores. Aloja más de 1,000 modelos de imagen, video, audio y 3D listos para producción tras una API unificada, incluidos modelos de terceros como FLUX, Veo, Kling y Seedream.
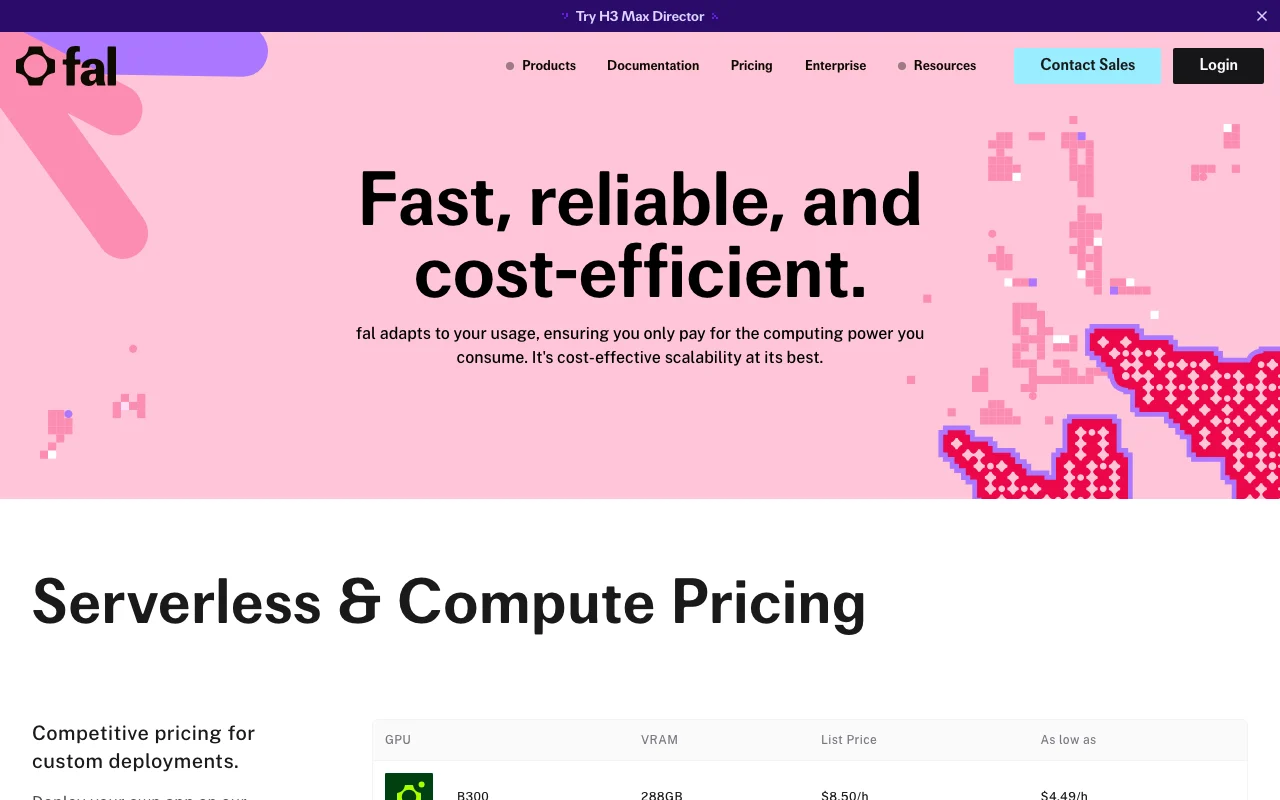
Además de las APIs de modelos, fal ofrece despliegues de GPU serverless para modelos personalizados o ajustados y clústeres de cómputo dedicados para entrenamiento. La facturación es de pago por uso, por resultado en las APIs de modelos y por hora en las GPUs.
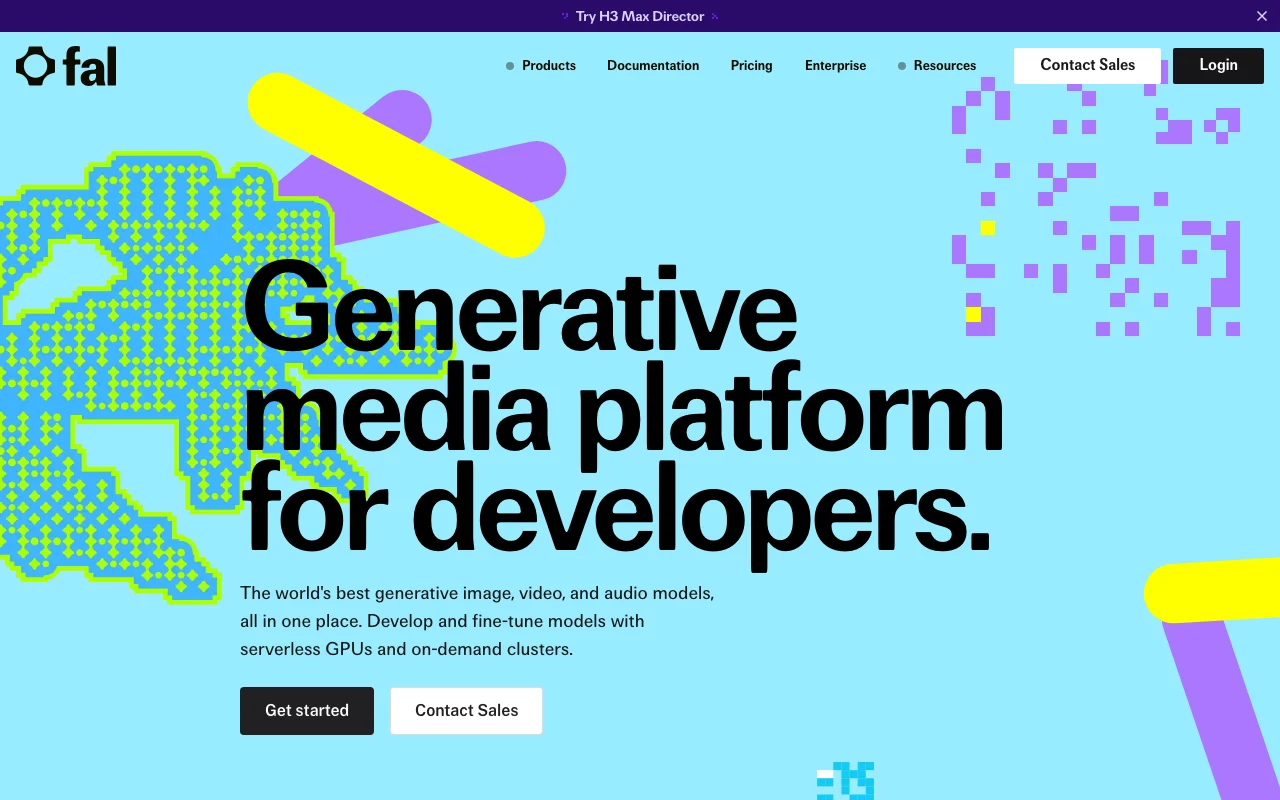
Sitio oficial de fal: cómo se presenta el producto. fal.ai, capturado Oct 1, 2026
Qué aportas y qué recibes
Qué le das a fal y qué devuelve, según su documentación
Lo que aportas
Prompts de texto
Imágenes o videos de referencia
Archivos de audio
Código de modelo personalizado (para despliegue)
Lo que recibes
Imágenes, videos, audio y modelos 3D generados
Síntesis de voz y efectos de sonido
Resultados de inferencia de modelos
Dónde puedes usarla
Plataformas
Web, API
Cuenta
Obligatorio
Modelos / versiones
1,000+ production-ready models
Mejores casos de uso de fal
Nuestros editores elaboran los escenarios a partir de la documentación; el resultado real depende de tu entrada y tu plan.
Añadir generación de imágenes o video a una aplicación
Quién
Desarrolladores frontend/full-stack
Lo que aportas
Prompts de texto o imágenes de referencia
Resultado esperado
Imágenes o videos generados mediante una llamada a la API
Resumen de funciones en el sitio oficial. fal.ai, capturado Oct 1, 2026
API unificada para más de 1,000 modelos generativos
Enruta una sola llamada a la API a más de 1,000 modelos de imagen, video, audio, música, 3D y voz Construye una vez y prueba muchos modelos sin rediseñar las integraciones
Acceso: API mediante los SDKs de fal (Python, JavaScript), REST o el playground webLímite: La disponibilidad y el rendimiento de los modelos varían; algunos modelos tienen restricciones regionalesfuente (se abre en una pestaña nueva)
Playground web y sandbox
Interfaz en el navegador para probar cualquier modelo, ajustar parámetros y comparar resultados Evalúa modelos antes de integrarlos sin escribir código
Acceso: Aplicación web en fal.ai; no se requiere registro para explorar, pero la inferencia requiere una clave de APILímite: El playground es informativo; las aplicaciones en producción requieren integración por APIfuente (se abre en una pestaña nueva)
Despliegues de GPU serverless
Despliega código Python personalizado con fal.App; escala automáticamente de 0 a más de 1000 GPUs Ejecuta modelos propietarios o ajustados con optimización de cold-start cero
Acceso: CLI de fal (fal deploy) y panel web; facturado por segundo de ejecuciónLímite: Solo Python para el despliegue; requiere la abstracción fal.Appfuente (se abre en una pestaña nueva)
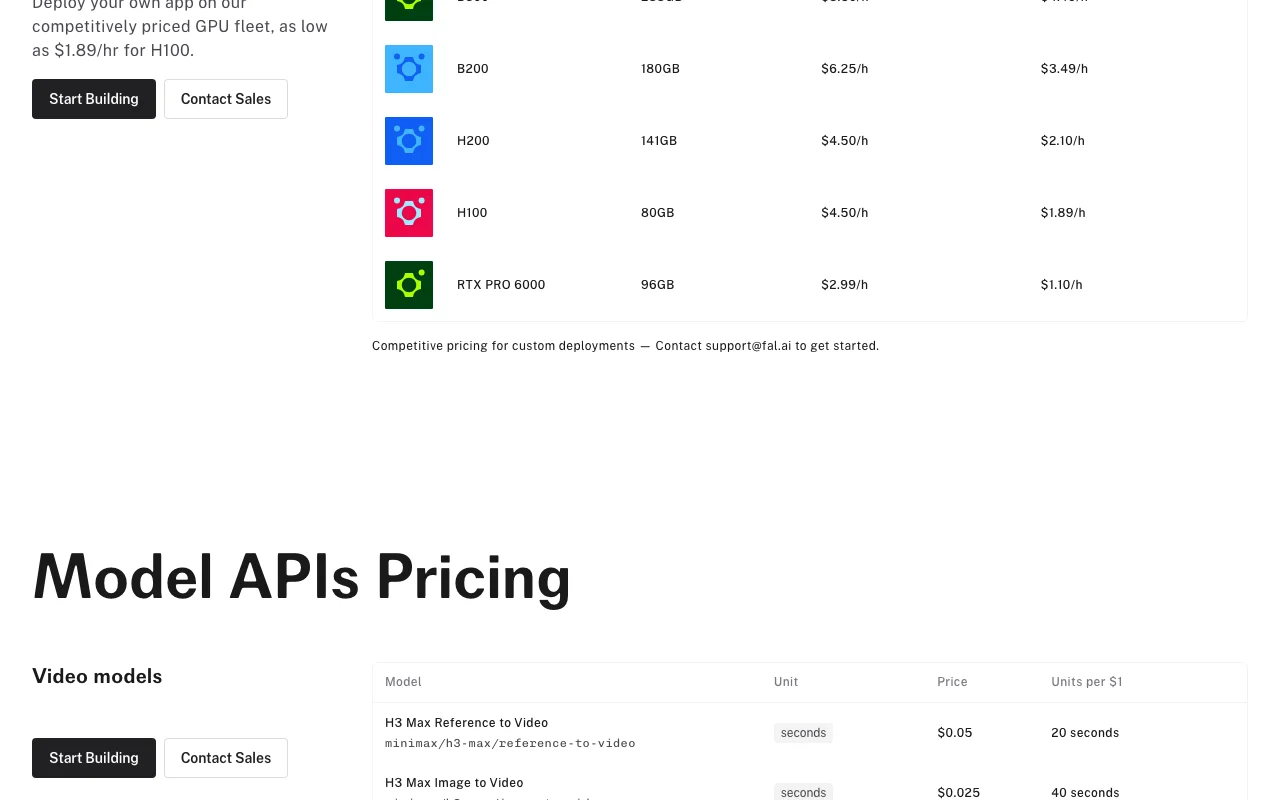
Cómputo dedicado H100/H200/B200/B300
Alquila instancias de GPU completas con acceso SSH total para entrenamiento, ajuste fino o trabajos por lotes Ejecuta cargas de trabajo largas a tarifa fija por hora sin la sobrecarga del autoescalado
Acceso: CLI de fal (fal compute create) y panel; facturación por hora de la instancia completaLímite: Requiere escalado manual; se factura la hora completa independientemente del usofuente (se abre en una pestaña nueva)
fal: puntos fuertes y límites
Motivos para elegir fal
Pagas solo por el uso, con precios por resultado publicados Costos predecibles para usuarios ligeros; sin cargos ocultos ni ataduras a una suscripcióndocumentadafuente (se abre en una pestaña nueva)
Amplia variedad de modelos de imagen, video y audio Los usuarios pueden experimentar con modelos de vanguardia como FLUX, Kling, MiniMax sin cambiar de plataformadocumentadafuente (se abre en una pestaña nueva)
Tarifas de GPU publicadas (H100 desde $1.89/h) Los precios transparentes permiten planificar el presupuesto y comparar con alternativasdocumentadafuente (se abre en una pestaña nueva)
Documentación, SDKs y playground Los desarrolladores pueden crear prototipos en el navegador antes de escribir código; los SDKs en varios lenguajes reducen la friccióndocumentadafuente (se abre en una pestaña nueva)
Revisa antes de pagar por fal
Sin suscripción fija; los costos escalan con el uso Facturas mensuales impredecibles para aplicaciones de alto volumen; sin tope de costo salvo que se aplique manualmentedocumentadafuente (se abre en una pestaña nueva)
Dirigido a desarrolladores, requiere integración por API Los usuarios no técnicos no pueden usar fal directamente; solo es adecuado para equipos con ingenieríadocumentadafuente (se abre en una pestaña nueva)
Algunos modelos usan precios basados en GPU Los costos de inferencia de modelos que usan mucha GPU pueden superar los precios de alternativas SaaSdocumentadafuente (se abre en una pestaña nueva)
Requiere una cuenta y una clave de API Sobrecarga de autenticación; no se puede usar sin registro y un método de pago registradodocumentadafuente (se abre en una pestaña nueva)
Cómo usar fal para crear una aplicación de medios generativos con modelos de IA orientados a API
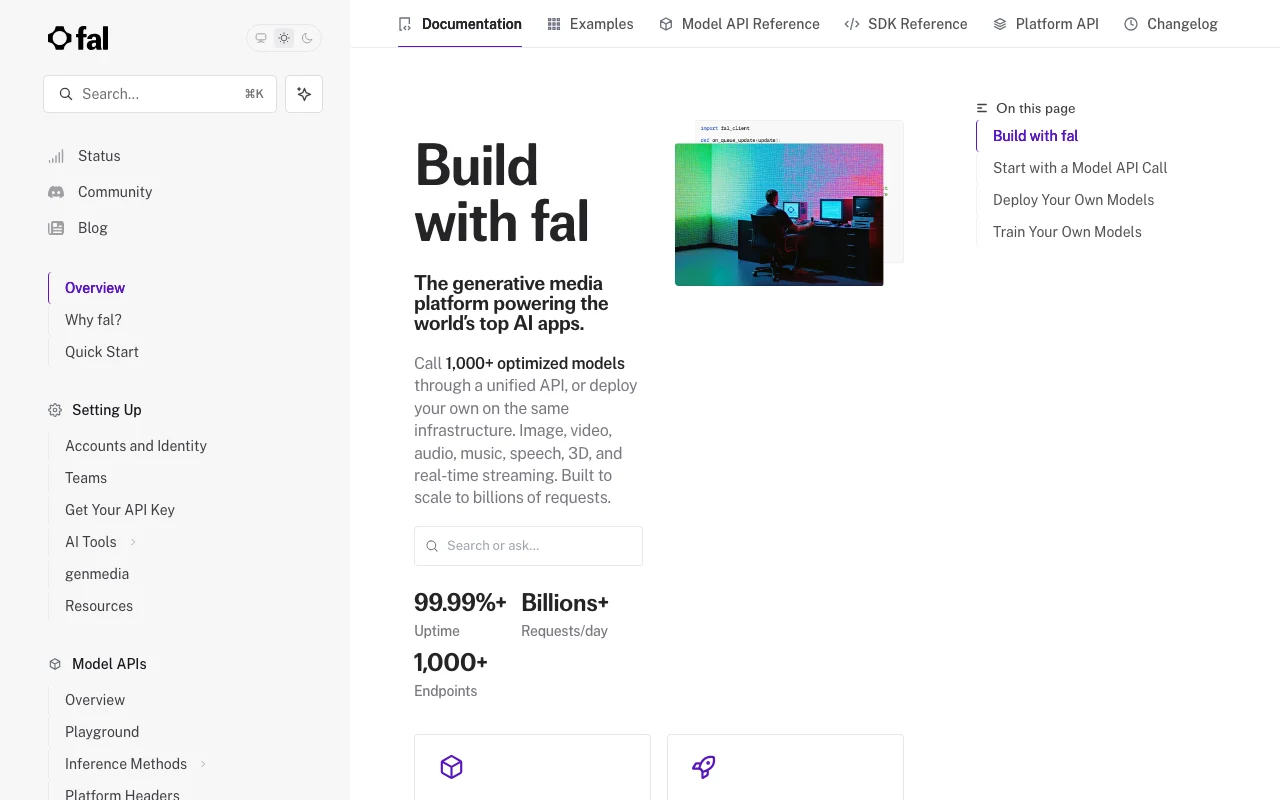
Documentación de fal: de dónde salen los pasos siguientes. fal.ai, capturado Oct 1, 2026
Configurar fal
Crea una cuenta de fal en https://fal.ai y verifica tu correo electrónico
Genera una clave de API en el panel (Settings > API Keys)
Instala el SDK de fal: pip install fal (Python) o npm install @fal-ai/client (JavaScript)
Ejemplo: crear una aplicación de medios generativos con modelos de IA orientados a API
Selecciona un modelo del Marketplace (p. ej., fal-ai/flux/schnell para imágenes)
Da formato a la entrada como JSON: {"prompt": "a sunset over mountains"}
Llama a la API con el SDK: fal_client.subscribe(model_id, arguments=input)
Revisa y exporta el resultado
Verifica que la respuesta contenga el campo output_url o de imagen/video/audio
Revisa Dashboard > Usage para el seguimiento de costos y los registros de solicitudes
Prompt de ejemplo sugerido por nuestros editores (no es una salida registrada del producto)
a sunset over mountains
fal integraciones y API
Documentación de fal (continuación). fal.ai, capturado Oct 1, 2026
Integraciones nativas y formatos de exportación
Exportar: Imágenes: PNG, JPG, WebP (según el modelo), Videos: MP4, WebM (varía según el modelo), Audio: WAV, MP3, OGG (varía según el modelo)
Acceso a la API y facturación aparte
fal no tiene una API pública en su documentación oficial. APIs REST y WebSocket; se admiten streaming asíncrono y en tiempo real Documentación de la API ↗
Privacidad, uso de datos y derechos comerciales
Resumido de las políticas vigentes del proveedor; no es asesoría legal y la insignia de un proveedor no es una auditoría independiente.
Cómo se tratan tus entradas y salidas
Los prompts de los usuarios, los archivos subidos y los resultados generados se almacenan para la prestación del servicio y el seguimiento del uso
fal puede usar entradas/salidas para mejorar sus modelos; los contratos empresariales pueden restringirlo
Se conservan según los términos del servicio; el periodo exacto no se especifica en el extracto de la política de privacidad
Uso comercial y restricciones del plan
Los clientes Enterprise pueden restringir por contrato el uso comercial de sus datos
Hay contratos Enterprise disponibles para restringir el uso de datos y las ubicaciones de procesamiento
fal no ofrece un plan gratuito; todo el uso es de pago por llamada. La documentación oficial de precios no menciona créditos gratuitos. fuente (se abre en una pestaña nueva)
¿Puedo desplegar mis propios modelos personalizados?
Sí. Usa fal Serverless para desplegar código Python con fal.App; la infraestructura escala automáticamente. El cómputo dedicado está disponible para entrenamiento y ajuste fino con acceso SSH completo. fuente (se abre en una pestaña nueva)
¿Cuál es la latencia de una llamada típica a la API?
Las APIs de modelos suelen responder en menos de un segundo; la generación de video puede tardar de 5 a 30 segundos según el modelo y los parámetros. Los despliegues serverless no tienen penalización de cold-start tras el primer uso. fuente (se abre en una pestaña nueva)
¿Admiten streaming en tiempo real?
Sí. Muchos modelos admiten llamadas de cola síncronas y asíncronas; hay conexiones WebSocket disponibles para inferencia en tiempo real en modelos seleccionados. fuente (se abre en una pestaña nueva)
¿Puedo usar fal con requisitos de seguridad empresariales?
Sí. Los clientes Enterprise obtienen cumplimiento SOC 2 Tipo II, SSO, endpoints privados y restricciones contractuales de tratamiento de datos. fuente (se abre en una pestaña nueva)
fal pricingpricing · revisado Oct 1, 2026 · Model API pricing (video, image, audio, 3D), GPU pricing (H100, H200, B200, B300, RTX PRO 6000), Serverless and compute tiers
fal documentationdocs · revisado Oct 1, 2026 · Model API quickstart, Serverless deployment guide, SDK references (Python, JavaScript), Compute provisioning
fal privacy policypolicy · revisado Oct 1, 2026 · Personal data collection and use, Third-party payment processor, GitHub OAuth option, Enterprise data handling
Sin verificar: free_access: No se menciona plan gratuito ni créditos gratuitos en los materiales oficiales; trial: No hay periodo de prueba documentado; taxes: Tratamiento de impuestos y exenciones no especificado; Periodo de retención de datos: la ventana exacta de retención no se indica en el extracto de la política de privacidad; Detalles del SLA: se afirma 99.99% de disponibilidad; no se proporciona un SLA formal; Capacidades de exportación/importación: no se documentan opciones de portabilidad de datos.
Cómo documentamos y mantenemos esta página
Todos los datos sobre fal de arriba provienen de las 4 páginas oficiales enumeradas aquí, comparadas por última vez el Sep 29, 2026; no hemos usado fal nosotros mismos, por eso no tiene puntuación editorial. Cómo revisamos y volvemos a revisar las páginas.
Artículo actualizado Oct 2, 2026; precios revisados Sep 29, 2026. Los enlaces salientes a proveedores son enlaces simples; no ganamos comisiones. Cómo reseñamos · Informar de un error