Unsere Einschätzung: Context.dev eignet sich für Entwickler, die KI-Agenten und RAG-Pipelines mit gescrapten Seiten, gecrawlten Websites, Markendaten und Antworten mit Quellen versorgen, kostenlos startend mit 1,000 Credits pro Monat.
Wichtigste Einschränkung: Der kostenlose Tarif hat keinen Mehrverbrauch und nur eine gleichzeitige Anfrage, und die Credit-Kosten steigen bei strukturierter Extraktion, Antworten und Browser-Aktionen schnell an.
Von den Redakteuren des AI Tool Atlas.
Auf Basis der offiziellen Dokumentation des Anbieters; wir haben dieses Produkt nicht selbst getestet. Was „dokumentierte Übersicht“ bedeutet
Für wen Context.dev passt
Context.dev eignet sich für Entwickler, die KI-Agenten und RAG-Pipelines mit gescrapten Seiten, gecrawlten Websites, Markendaten und Antworten mit Quellen versorgen, kostenlos startend mit 1,000 Credits pro Monat. Auf Basis der Dokumentation des Anbieters, nicht in einem praktischen Test.
Am besten für: Entwickler, die KI-Agenten bauen
Auch gut geeignet für
Teams, die Webdaten für RAG brauchen
Ein anderes Tool in Betracht ziehen, wenn der kostenlose Tarif hat keinen Mehrverbrauch und 1 gleichzeitige Anfrage
Oder wenn
Erfordert ein Konto und einen API-Schlüssel
Nutzung auf Credit-Basis; intensivere Nutzung erfordert kostenpflichtige Tarife
Context.dev Preise und Nutzungslimits
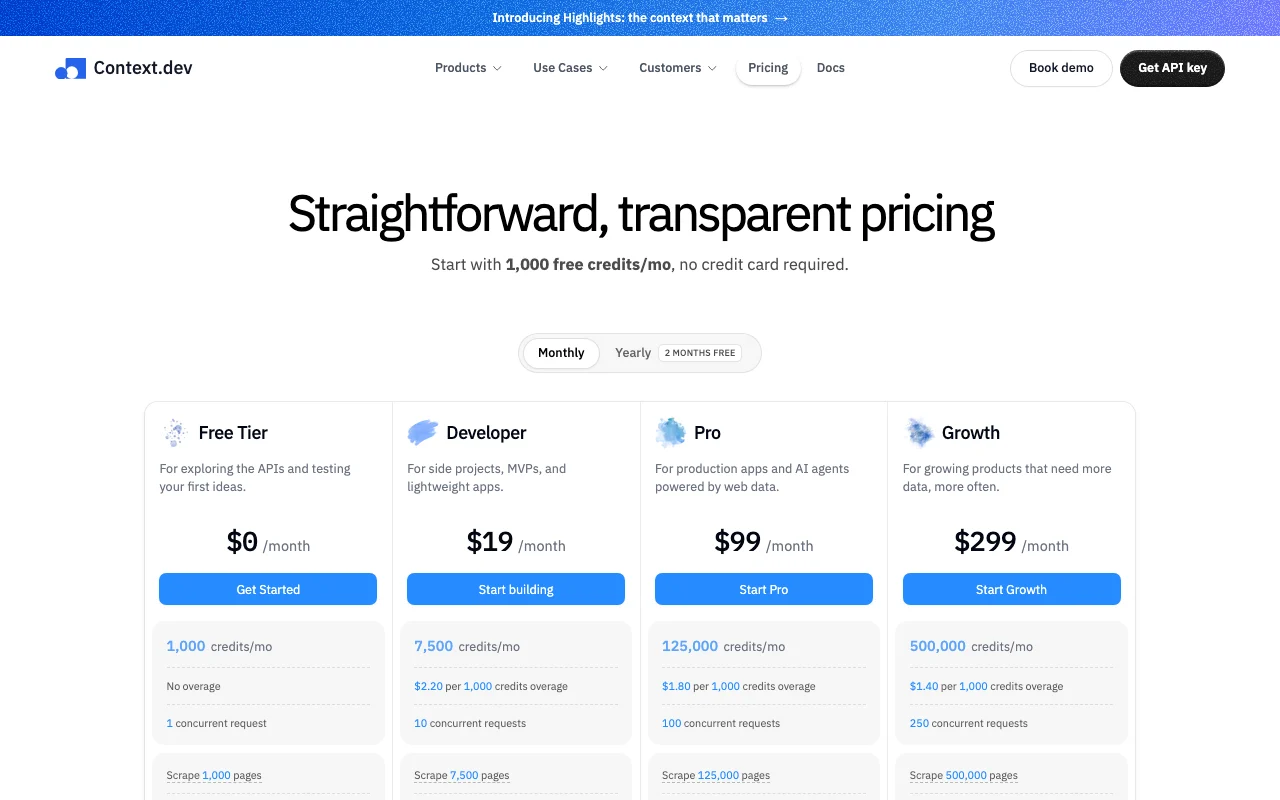
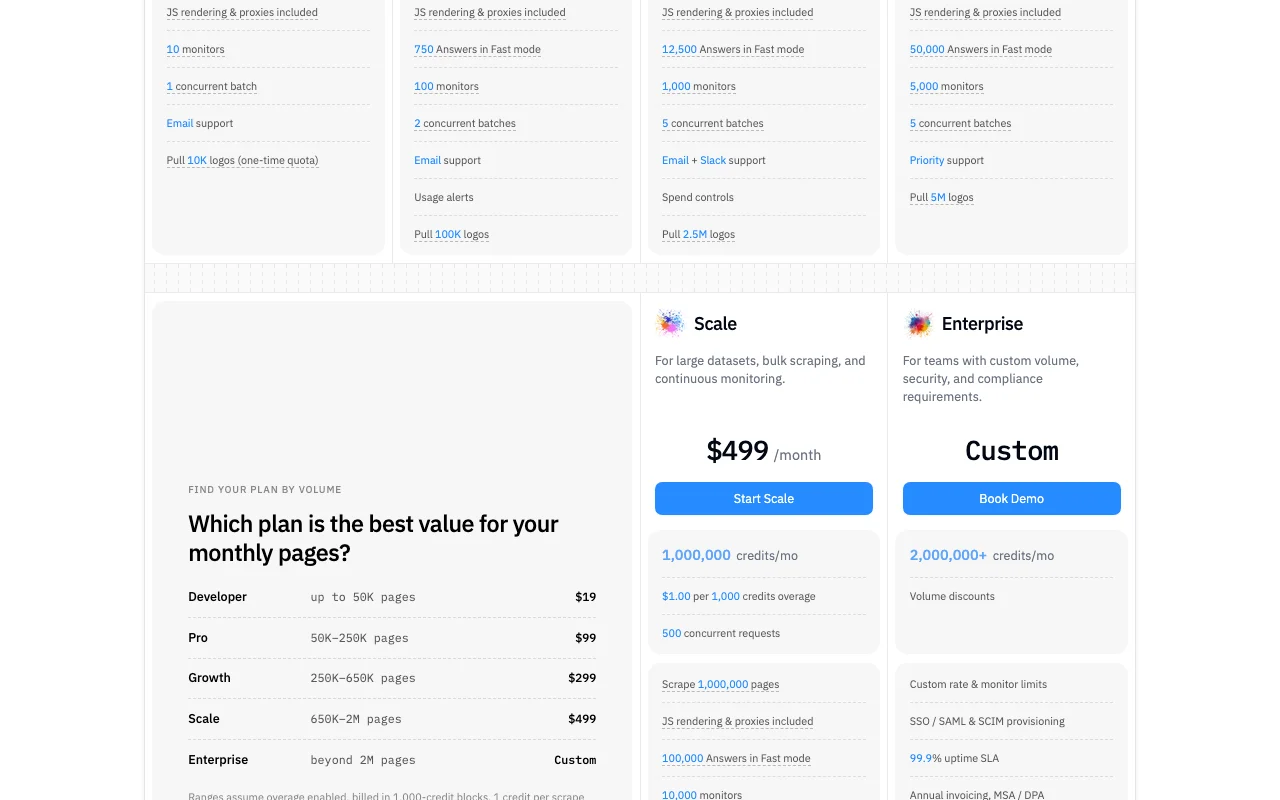
Preise am Oct 1, 2026 auf der offiziellen US-Preisseite geprüft. Offizielle Preise ↗ Preise und Limits ändern sich häufig.
Die offizielle Context.dev-Preisseite, wie wir sie gesehen haben. context.dev, erfasst Oct 1, 2026
Kostenloser Zugang und Testbedingungen
1,000 Credits pro Monat ohne Kreditkarte.
Keine Testphase über den kostenlosen Tarif hinaus.
Kostenpflichtige Tarife: was sich beim Upgrade ändert
Mehrverbrauch und Auto-Topup in Blöcken zu 1K Credits; aufwendigere Aufrufe kosten mehr Credits (JSON-Extraktion 5, Answers ab 10).
Nicht angegeben.
Was ist Context.dev und wie funktioniert es?
Context.dev ist eine Web-Daten-API, die Markdown, HTML, Screenshots und strukturierte Felder von jeder URL liefert und ganze Domains kartieren und crawlen kann.
Sie bietet außerdem Batch-Jobs, Änderungsmonitore, Rechercheantworten mit Quellen und Markendaten von Unternehmen, mit SDKs und einer agentengestützten Einrichtung.
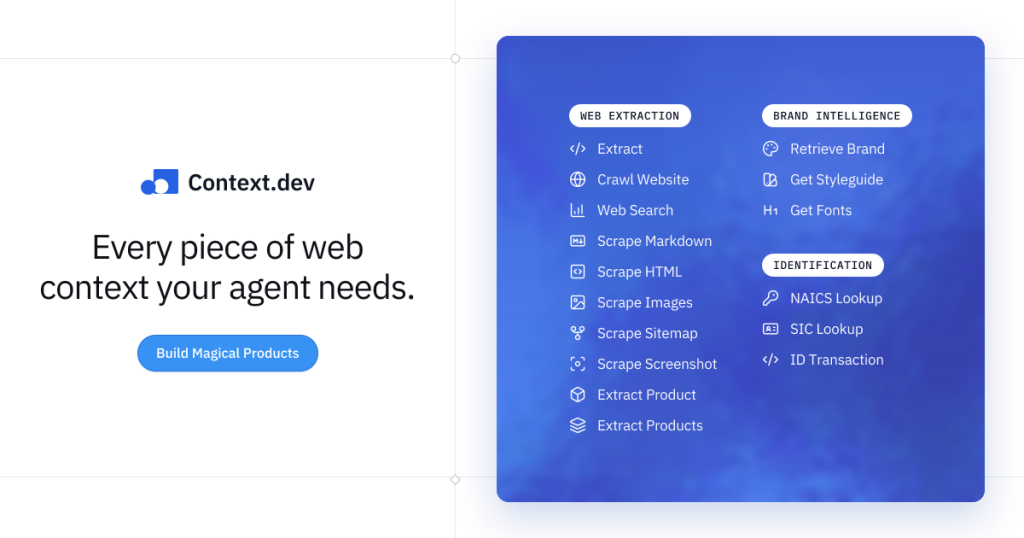
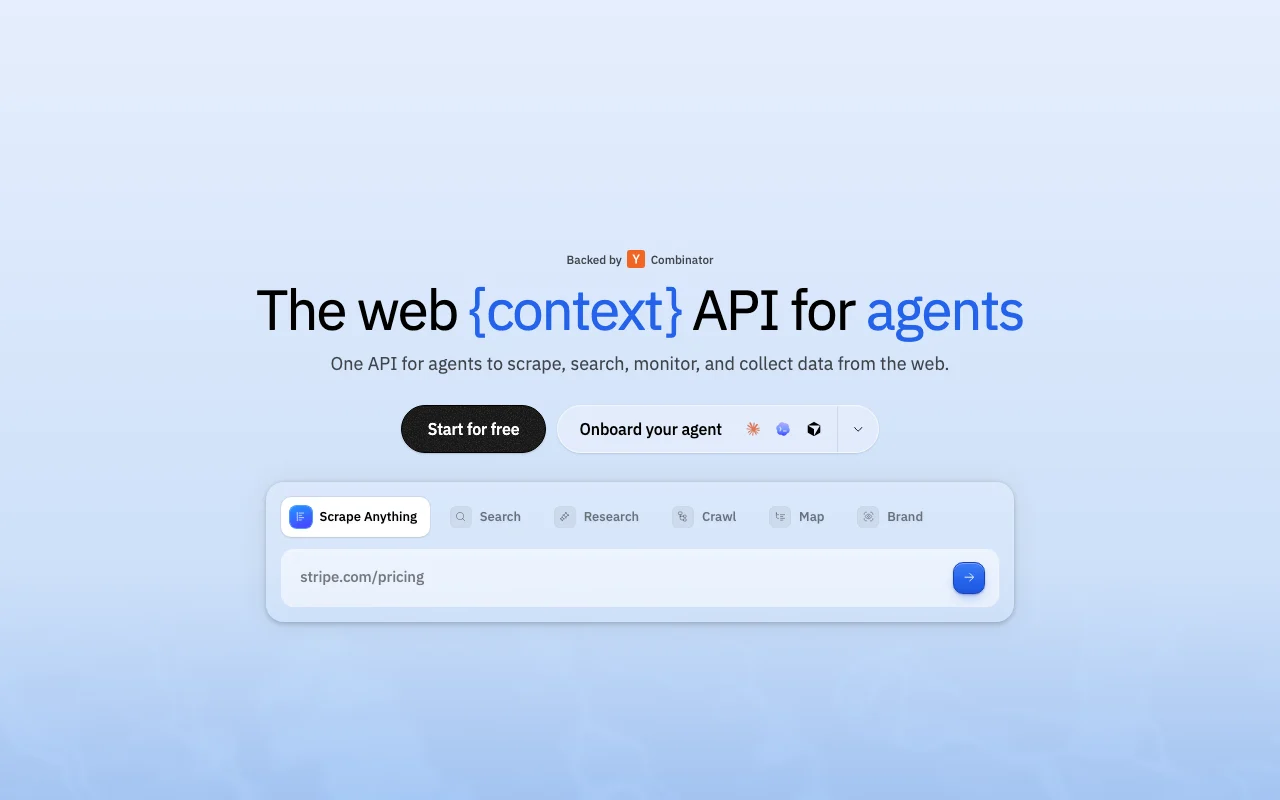
Offizielle Website von Context.dev: So stellt sich das Produkt selbst dar. context.dev, erfasst Oct 1, 2026
Was Sie liefern und was Sie erhalten
Was Sie Context.dev geben und was zurückkommt, laut Dokumentation
Sie liefern
URLs, Domains oder Suchanfragen
JSON-Schemas für die Extraktion
Batch- oder Crawl-Jobs
Sie erhalten zurück
Markdown, HTML, Bilder und Screenshots
Strukturiertes JSON
Antworten mit Quellen
Markendaten und Styleguides
Wo Sie es nutzen können
Plattformen
API
Konto
Erforderlich
Credit-Kosten
Scrape 1, JSON-Extraktion 5, Crawl 1 pro Seite, Answers 10 (Fast) oder 100 (Ultra)
Parallelität
1 / 10 / 100 / 250 / 500 je nach Tarif
Standard-Timeout
90 Sekunden, erhöhbar auf 300,000 ms
Jährliche Abrechnung
2 Monate gratis
Wofür Context.dev genutzt wird
Die Szenarien erarbeiten unsere Redakteure anhand der Dokumentation; das tatsächliche Ergebnis hängt von Ihrer Eingabe und Ihrem Tarif ab.
Führt große Jobs mit Paginierung oder Webhooks bei Abschluss aus. Bewältigt Mengen jenseits einzelner Aufrufe.
Zugriff: 1 bis 20 gleichzeitige Batches je nach TarifLimit: Gleichzeitige Batches sind je Tarif begrenzt.Quelle (öffnet in neuem Tab)
Antworten aus dem Web mit Quellen
Liefert Antworten mit Quellen für 10 Credits im Fast-Modus oder 100 im Ultra-Modus. Erspart den Aufbau einer Kette aus Suche und LLM.
Zugriff: Fast-Modus-Kontingente ab DeveloperLimit: Der Ultra-Modus ist zehnmal teurer.Quelle (öffnet in neuem Tab)
Abruf von Marken- und Styleguide-Daten
Ruft die Markendaten eines Unternehmens ab oder extrahiert einen Styleguide für 10 Credits pro Aufruf. Reichert Produkte mit Logos und Farben an.
Zugriff: Alle TarifeLimit: Markendaten werden unter Umständen bis zu etwa 90 Tage zwischengespeichert.Quelle (öffnet in neuem Tab)
Vor- und Nachteile sowie Ausschlusskriterien
Wo Context.dev stark ist
Kostenloser Tarif mit 1,000 Credits pro Monat, ohne Karte Sie können ohne Karte testen und zuerst die Ausgabequalität beurteilen.dokumentiertQuelle (öffnet in neuem Tab)
Die Preise nennen USD-Tarife und Mehrverbrauchssätze pro 1,000 Credits Die Sätze für Mehrverbrauch sinken mit höheren Tarifen von $2.20 auf $1.00 pro 1,000 Credits, daher sind die Kosten planbar.dokumentiertQuelle (öffnet in neuem Tab)
JS-Rendering und Proxys in den Tarifen enthalten Anti-Bot-Handling und Rendering brauchen keine Zusatzpakete, daher kostet ein normaler Scrape 1 Credit.dokumentiertQuelle (öffnet in neuem Tab)
Offizielle SDKs in fünf Sprachen SDKs für TypeScript, Python, Ruby, Go und PHP werden bereitgestellt.dokumentiertQuelle (öffnet in neuem Tab)
Rabatt für Startups und Non-Profits Berechtigte Organisationen erhalten 12 Monate lang 30% Rabatt auf Jahrestarife.dokumentiertQuelle (öffnet in neuem Tab)
Einschränkungen, die Sie vor dem Bezahlen prüfen sollten
Der kostenlose Tarif hat keinen Mehrverbrauch und 1 gleichzeitige Anfrage Das Erreichen des Monatslimits bei Free stoppt den Dienst, statt weiter abzurechnen.dokumentiertQuelle (öffnet in neuem Tab)
Erfordert ein Konto und einen API-Schlüssel Ohne Registrierung und Schlüsselverwaltung ist keine Nutzung möglich.dokumentiertQuelle (öffnet in neuem Tab)
Nutzung auf Credit-Basis; intensivere Nutzung erfordert kostenpflichtige Tarife Die Kosten steigen mit JSON-Extraktion, Answers und Browser-Aktionen.dokumentiertQuelle (öffnet in neuem Tab)
Nur API, keine eigenständige App bestätigt Teams, die einen visuellen Scraper wollen, müssen eine eigene Oberfläche bauen.dokumentiertQuelle (öffnet in neuem Tab)
Fehlgeschlagene 404-Anfragen werden trotzdem berechnet Antworten vom Typ „nicht gefunden“ werden zum Grundpreis berechnet.dokumentiertQuelle (öffnet in neuem Tab)
So nutzen Sie Context.dev für eine Website für RAG als Markdown crawlen
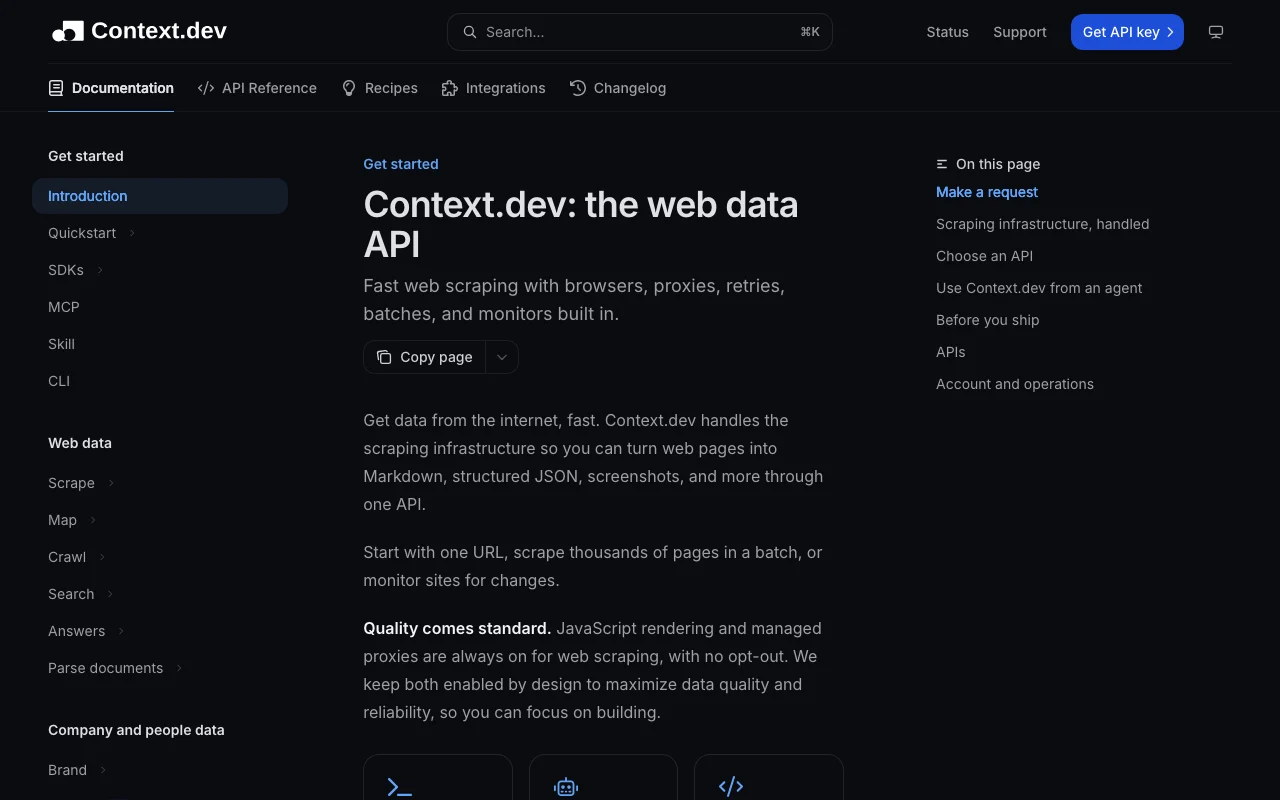
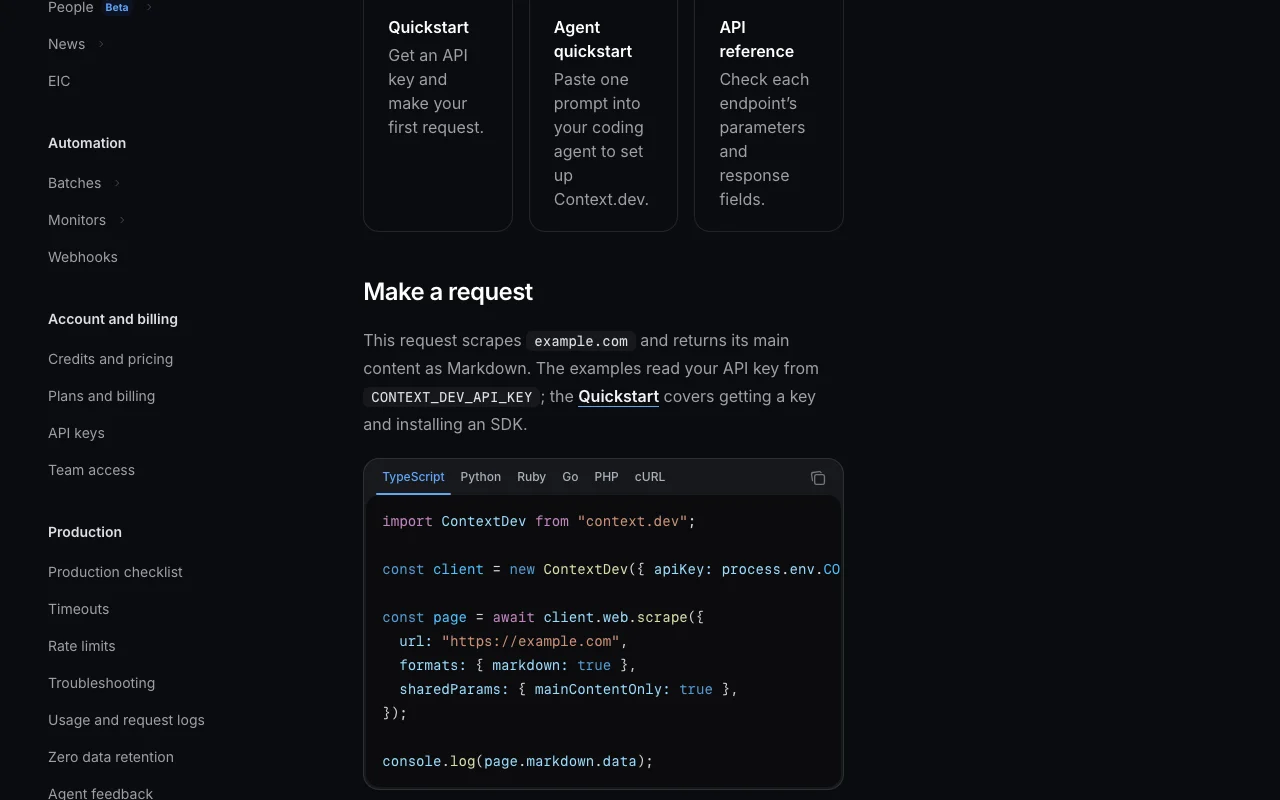
Context.dev Dokumentation: Quellen der folgenden Schritte. docs.context.dev, erfasst Oct 1, 2026
Context.dev einrichten
Ein kostenloses Konto auf context.dev erstellen; eine Kreditkarte ist nicht nötig.
Im Dashboard einen API-Schlüssel erzeugen.
Das SDK für TypeScript, Python, Ruby, Go oder PHP installieren oder die REST-API aufrufen.
Einen ersten Scrape ausführen, um den Credit-Verbrauch zu sehen.
Beispiel: eine Website für RAG als Markdown crawlen
Map auf die Domain anwenden, um deren URLs aufzulisten.
Crawl mit Tiefe, Seitenlimit und URL-Mustern aufrufen.
Bei größeren Websites einen Batch im Crawl-Modus starten und einen Webhook bei Abschluss setzen.
Das zurückgegebene Markdown in Ihren Vektorspeicher indexieren.
Ergebnis prüfen und exportieren
key_metadata.credits_consumed in den Antworten lesen.
Prüfen, ob die Seitenzahlen Ihren Erwartungen entsprechen.
Auf 401 USAGE_EXCEEDED achten, wenn die Credits aufgebraucht sind.
Context.dev Integrationen und API
Context.dev Dokumentation (Fortsetzung). docs.context.dev, erfasst Oct 1, 2026
Native Integrationen und Exportformate
Export: Markdown, HTML, JSON, Screenshots
API-Zugang und separate Abrechnung
Context.dev hat laut offizieller Dokumentation keine öffentliche API. Dasselbe Credit-Guthaben gilt für alle APIs. API-Dokumentation ↗
Datenschutz, Datennutzung und kommerzielle Rechte
Zusammengefasst aus den aktuellen Richtlinien des Anbieters; dies ist keine Rechtsberatung, und das Badge eines Anbieters ersetzt kein unabhängiges Audit.
Wie Ihre Eingaben und Ausgaben verarbeitet werden
Sendet Ziel-URLs und Anfragen; die Datenschutzerklärung deckt erhobene personenbezogene Daten ab.
Ein normaler Scrape verbraucht 1 Credit, Browser-Aktionen machen daraus 2, und eine erfolgreiche JSON-Extraktion kostet 4 mehr. Quelle (öffnet in neuem Tab)
Werden fehlgeschlagene Anfragen berechnet?
Die meisten fehlgeschlagenen Anfragen werden nicht berechnet, aber 404-Antworten („nicht gefunden“) werden zum Grundpreis berechnet. Quelle (öffnet in neuem Tab)
Was passiert, wenn die Credits aufgebraucht sind?
Kostenpflichtige Tarife können Auto-Topup in Blöcken zu 1K Credits nutzen; ohne Credits oder Aufladung gibt die API 401 USAGE_EXCEEDED zurück. Quelle (öffnet in neuem Tab)
Kann ich eine ganze Website crawlen?
Ja, Crawl scrapt bis zu 500 Seiten pro Aufruf als Markdown, und Batches im Crawl-Modus bewältigen größere Websites. Quelle (öffnet in neuem Tab)
Nicht verifiziert: Nutzung von Kundendaten für Training; Aufbewahrungsfristen für Daten.
Wie wir diese Seite dokumentiert haben und pflegen
Jede Angabe zu Context.dev oben stammt aus den 4 hier aufgeführten offiziellen Seiten, zuletzt verglichen am Oct 1, 2026; wir haben Context.dev nicht selbst getestet, daher gibt es keine redaktionelle Bewertung. Wie wir Seiten prüfen und erneut prüfen.
Artikel aktualisiert Oct 10, 2026; Preise geprüft Oct 1, 2026. Ausgehende Links zu Anbietern sind einfache Links; wir erhalten keine Provisionen. So testen wir · Fehler melden