Free Web
Grátis fonte (abre em uma nova guia)
Pagamento único
Para: Early validation
Limites
- 5,000 one-time credits
- Fetch 30 req/min
1 mais
- Browser 1 concurrent
Inclui
- $0 per credit
API incluída
ProgramaçãoVisão geral documentadaÚltima verificação Sep 29, 2026
API de web scraping e busca que devolve Markdown limpo a partir de URLs para agentes de IA e RAG, com capturas de tela.
 (abrir em tamanho real em uma nova guia)
 (abrir em tamanho real em uma nova guia)
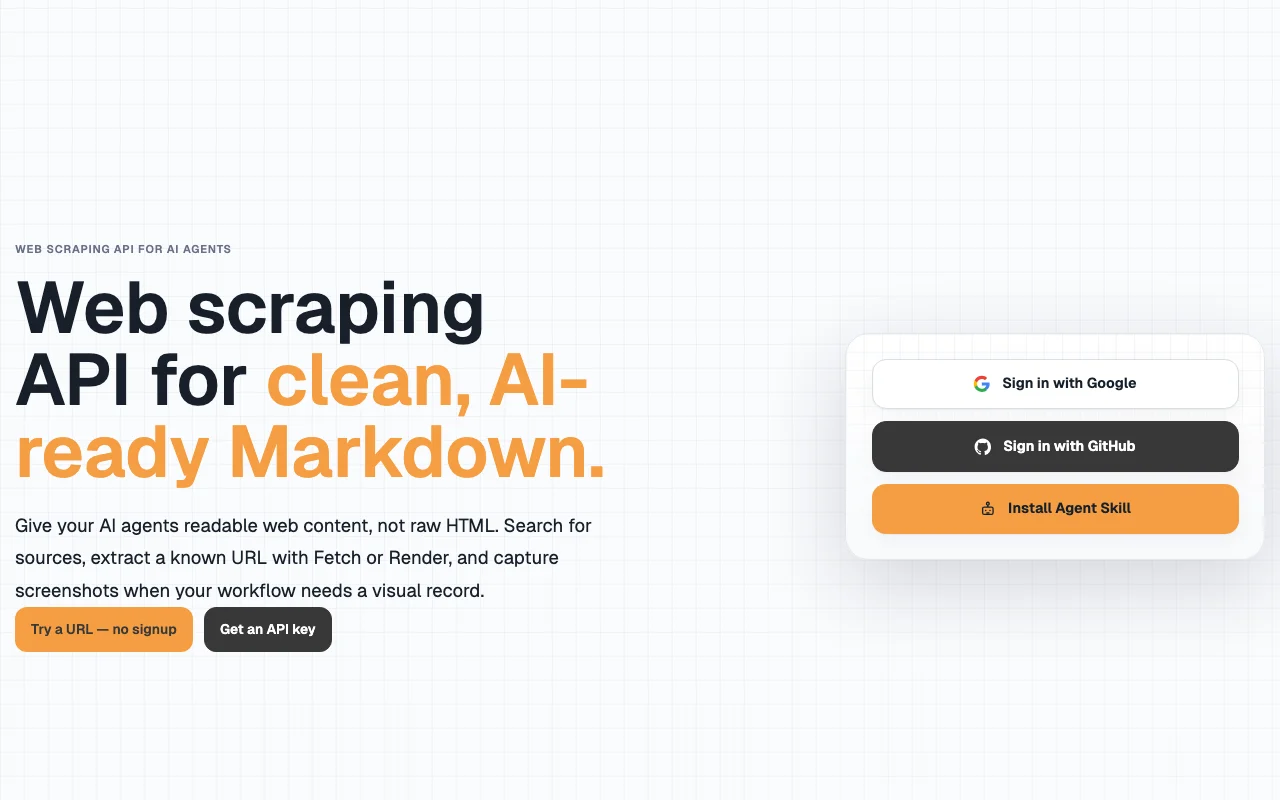 (abrir em tamanho real em uma nova guia)
 (abrir em tamanho real em uma nova guia)
 (abrir em tamanho real em uma nova guia)
Nossa opinião: Escolha o AnyCrawler quando agentes de IA ou pipelines de RAG precisarem de Markdown limpo de páginas ao vivo, com custos de crédito por solicitação publicados, começando de graça com 5.000 créditos únicos.
Principal limitação: O uso é medido em créditos (fetch 2, render 10, capturas de tela de 20 a 50 créditos) e os créditos gratuitos são únicos, não mensais.
Escolha o AnyCrawler quando agentes de IA ou pipelines de RAG precisarem de Markdown limpo de páginas ao vivo, com custos de crédito por solicitação publicados, começando de graça com 5.000 créditos únicos. Com base na documentação do fornecedor, fora de um teste prático.
Também indicado para
Ou se
Preços verificados em Sep 29, 2026 na página oficial de preços dos EUA. Preços oficiais ↗ Preços e limites mudam com frequência.
Plano gratuito com 5.000 créditos únicos; uma ferramenta de teste de URL não exige cadastro.
Sem teste separado.
Grátis fonte (abre em uma nova guia)
Pagamento único
Para: Early validation
Limites
Inclui
API incluída
$5/mo fonte (abre em uma nova guia)
Mês
Para: Low-frequency agents
Limites
Inclui
API incluída
$20/mo fonte (abre em uma nova guia)
Mês
Para: Shipping crawler workflows
Limites
Inclui
API incluída
$80/mo fonte (abre em uma nova guia)
Mês
Para: Production scraping teams
Limites
Inclui
API incluída
$200/mo fonte (abre em uma nova guia)
Mês
Para: High-volume pipelines
Limites
Inclui
API incluída
Recargas persistentes vendidas separadamente; campos opcionais acrescentam 1 crédito cada; condições para volumes maiores pelo suporte.
Não informado.
O AnyCrawler é uma API baseada em créditos que transforma páginas da web em Markdown. O Fetch lê o HTML inicial da página, o Render a carrega antes em um navegador, e endpoints separados cobrem busca na web e capturas de tela. O acesso é feito por uma chave de API e uma conta web (login com Google ou GitHub). Uma ferramenta gratuita permite que os visitantes testem uma URL sem se cadastrar.
O que você fornece
O que você recebe de volta
Os cenários são elaborados por nossos editores a partir da documentação; o resultado real depende da sua entrada e do seu plano.
Lê o HTML inicial da página e devolve Markdown por 2 créditos. Extração barata quando não é preciso JavaScript.
Carrega a página primeiro em um navegador e devolve Markdown por 10 créditos de base. Obtém conteúdo que só aparece depois que os scripts rodam.
Endpoints separados para busca de web, imagem, notícias, vídeo e acadêmica, a 2 créditos por resultado. Encontra páginas de origem antes do rastreamento.
Captura PNGs da viewport (20 créditos) ou da página inteira (50 créditos). Registro visual junto da saída estruturada.
Exportar: Markdown, JSON, PNG
AnyCrawler não tem API pública na documentação oficial. API REST com endpoint de uso /v1/account/usage; a URL da documentação retornou 404 na análise
Resumido a partir das políticas atuais do fornecedor; não é aconselhamento jurídico, e o selo de um fornecedor não é uma auditoria independente.
URLs de destino, consultas de busca, metadados das solicitações e resultados de rastreamento são processados para devolver os resultados.
Não informado no texto analisado.
Varia conforme o tipo de dado, segundo a política; detalhes não registrados.
A política diz que o AnyCrawler não reivindica a propriedade do conteúdo que você acessa; você é responsável pela base legal.
Não informado.
Políticas: anycrawler.com/privacy/
"Mais indicado" se baseia em recursos e preços documentados, não em um teste comparativo direto.
| Alternativa | Quando escolher | Preços | Limitação | |
|---|---|---|---|---|
| Perplexity | — | — |
Ainda não há avaliações de usuários.
Usado AnyCrawler? Seja o primeiro a compartilhar sua experiência.
O fetch custa 2 créditos de base e devolve Markdown do HTML inicial; o render custa 10 créditos de base após carregar a página em um navegador. fonte (abre em uma nova guia)
No custo base, cerca de 2.500 fetches, 500 renders, 250 capturas de viewport ou 100 capturas de página inteira. fonte (abre em uma nova guia)
Sim: os limites de fetch vão de 60 solicitações por minuto no Agent Lite a 1.200 no Scale, e a simultaneidade de navegadores vai de 2 a 20. fonte (abre em uma nova guia)
Com accept_cache=true, um acerto válido no cache do render tem custo base de 1 crédito; os campos opcionais ainda podem acrescentar créditos. fonte (abre em uma nova guia)
include_metadata, include_links e include_media acrescentam 1 crédito cada no fetch e no render. fonte (abre em uma nova guia)
Não verificado: Conteúdo da documentação; Política sobre dados de treinamento; Períodos exatos de retenção.
Todos os fatos sobre AnyCrawler acima vêm de 2 páginas oficiais listados aqui, comparados pela última vez em Sep 29, 2026; não executamos AnyCrawler por conta própria, por isso ele não tem nota editorial. Como verificamos e reverificamos as páginas.
Artigo atualizado em Oct 10, 2026; preços verificados Sep 29, 2026. Os links para fornecedores são links comuns; não ganhamos comissões. Como avaliamos · Relatar um erro
compare>